黄仁勋可能怎么也没想到,自己筑了二十年的CUDA高墙,会被一家年轻的中国大模型公司用最干脆的方式给拆了墙角。
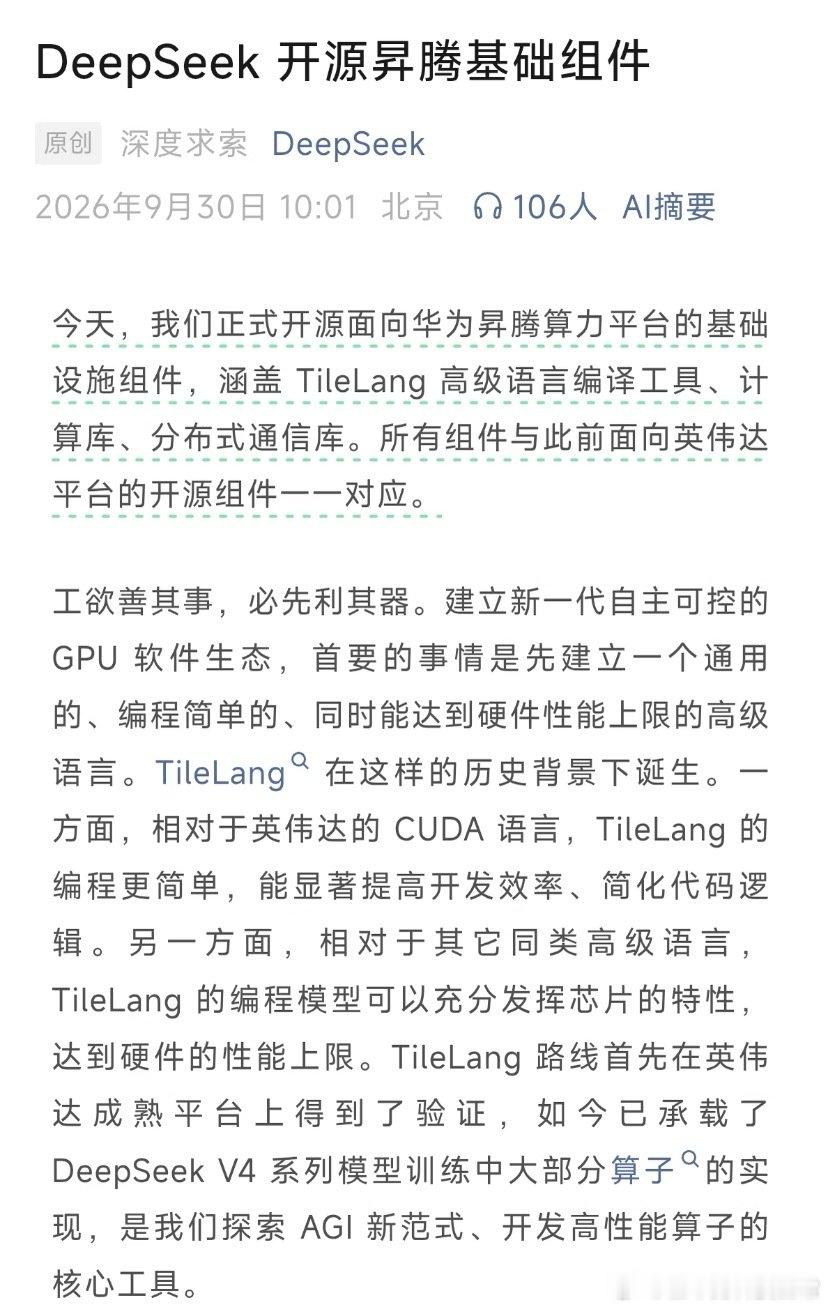
国庆前夕,DeepSeek做了一个让硅谷摸不着头脑的决定:把面向华为昇腾芯片的一整套开发工具和底层高性能算子,直接开源了。
这件事的看点,藏在一个普通人很少接触的问题里:买到了芯片,为什么还不一定能把人工智能做好?
打个比方,芯片像厨房里的灶台,模型像一道复杂的菜。灶台火力再大,也得有人安排切菜、下锅、翻炒。软件工具就是这套手艺,安排得不好,昂贵的机器也会闲着等活。
英伟达的厉害之处,就在于它把灶台和做菜的工具一起提供了。
2006年,英伟达推出CUDA,让开发者能够调用显卡的并行计算能力,去做科学计算等工作。此后,围绕CUDA积累起来的计算库、开发工具和应用经验,逐渐成为它的重要竞争优势。
企业选芯片,当然要比速度、价格,但还要问:工程师熟不熟悉?现成的软件能不能用?出了问题好不好查?换一个平台,需要重新花多少时间?
旧平台上积累的程序、经验和人才,都会影响下一次采购。工具越成熟,企业越愿意继续使用;使用的人越多,工具又越容易完善。这才是那堵“高墙”难跨的地方。
DeepSeek这次下手的,正是这笔换平台的成本。
9月30日,面向昇腾的编译工具、计算库和通信库一起亮相。TileLang新增对昇腾950的正式支持,DeepGEMM和DeepEP也拿出了昇腾版本。
名字听着拗口,干的事情却不难理解:让程序更好写,让芯片算得更快,让许多芯片一起干活时少堵车。
先说TileLang。开发者可以用接近Python的写法编写高性能算子,再由编译工具处理一部分底层安排。所谓算子,就是模型处理数据时反复执行的具体计算步骤。
它像一位翻译,帮助开发者把计算任务交代给芯片,同时保留进一步优化的空间。对于需要不断试验新算法的团队,这类工具的价值,就在于减少与底层细节反复较劲的时间。
再看DeepGEMM,它主要负责矩阵运算。大模型里面,大量工作都是一排排数字相乘、相加。这些基础计算重复得极多,哪怕单次只省下一点时间,累计起来也可能影响整个服务的成本。
昇腾版DeepGEMM兼容原有接口和开发流程,意味着使用这套库的开发者,可以沿用已有的调用方式。这种衔接,恰好落在企业最关心的地方:迁移时,能少改多少代码?
它在昇腾950DT上的一项指定BF16矩阵运算测试中,达到了硬件理论上限的99.8%。这个数字对应的是具体测试条件,但也说明,开源代码已经深入到怎样把硬件能力用足的环节。
DeepEP解决的则是另一道难题:芯片之间传数据。
DeepSeek采用的混合专家架构,可以理解为把任务分给不同“专家”处理。专家分布在不同芯片上,数据就要来回运送。每颗芯片单独算得快,传输环节跟不上,整个队伍照样要排队。
通信库就是替这支队伍安排运输。昇腾版DeepEP把相关接口与英伟达版本对齐,帮助开发者接续原有的使用方式。计算和通信一起优化,才能让一群芯片更有效地协作。
与此同时,TileKernels、FlashMLA、DeepSelect等组件,也覆盖了其他计算、注意力处理和数据筛选环节。开发者得到的,是多个关键环节的实现代码,能够查看、测试,再按自己的需求修改。
这条路有一个逐步深入的过程。
2024年12月,DeepSeek-V3发布时就支持昇腾推理。到了2025年2月,DeepSeek系列模型上线昇腾社区,三家基础电信企业也相继基于昇腾生态接入相关服务。
当时,很多人的关注点是:国产芯片能不能把模型运行起来?
如今,把开发工具、核心计算和通信组件进一步开放,关注点就往前推进了一步:怎样让它更容易开发、更有效率,也更方便其他团队继续改进?
我认为,这次开源最值得重视的,正是这种可以接着做的能力。
一家企业把优化成果留在内部,受益范围主要在自己。一旦代码开放,其他开发者就有机会在同一基础上找问题、补功能、做适配,少走一些重复摸索的路。
参与的人能否越来越多,成果能否持续更新,才决定这条路能走多远。开源把入口打开了,后面的生态建设仍需要长期投入。
对国产芯片来说,软件好用,就更有机会进入真实业务;真实业务多了,问题和需求又会推动软硬件继续改进。这种循环一旦形成,竞争就会从单颗芯片的参数,延伸到整套系统的使用成本。
对于企业用户,多一种能用、愿意用的选择,也意味着在采购、部署和技术路线安排上,多一点主动权。
所以,在我看来,“拆墙角”的意义,在于围绕CUDA形成的使用习惯,开始面对更多可供实践的替代路径。谁能把工具做得顺手,把服务做得稳定,把成本算得明白,谁就更有机会留住开发者。