DeepSeek又双叒叕在深夜搞事情了!
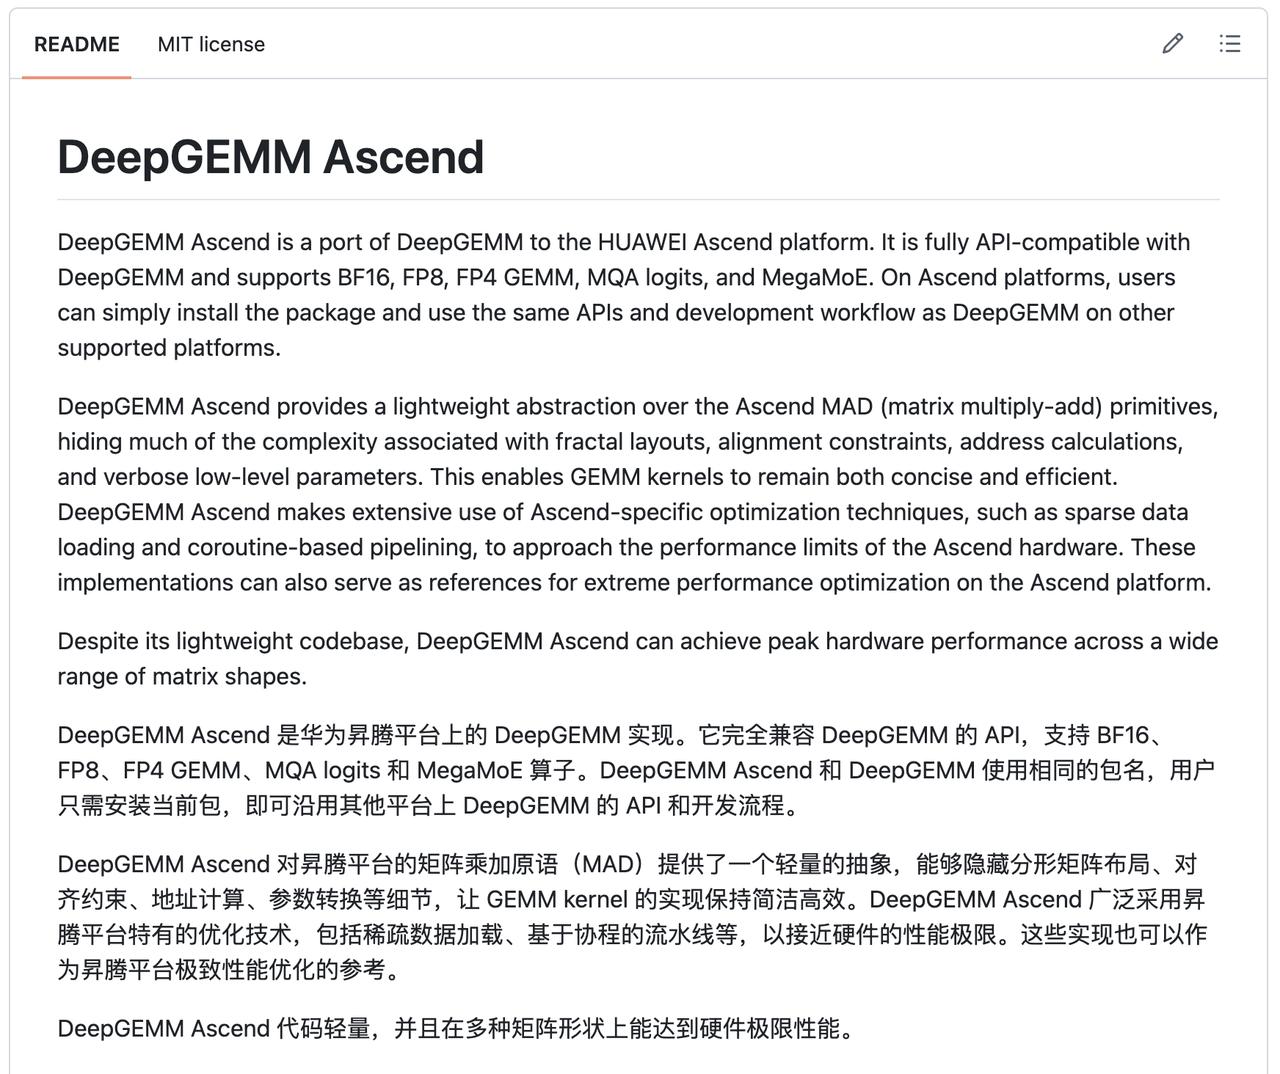
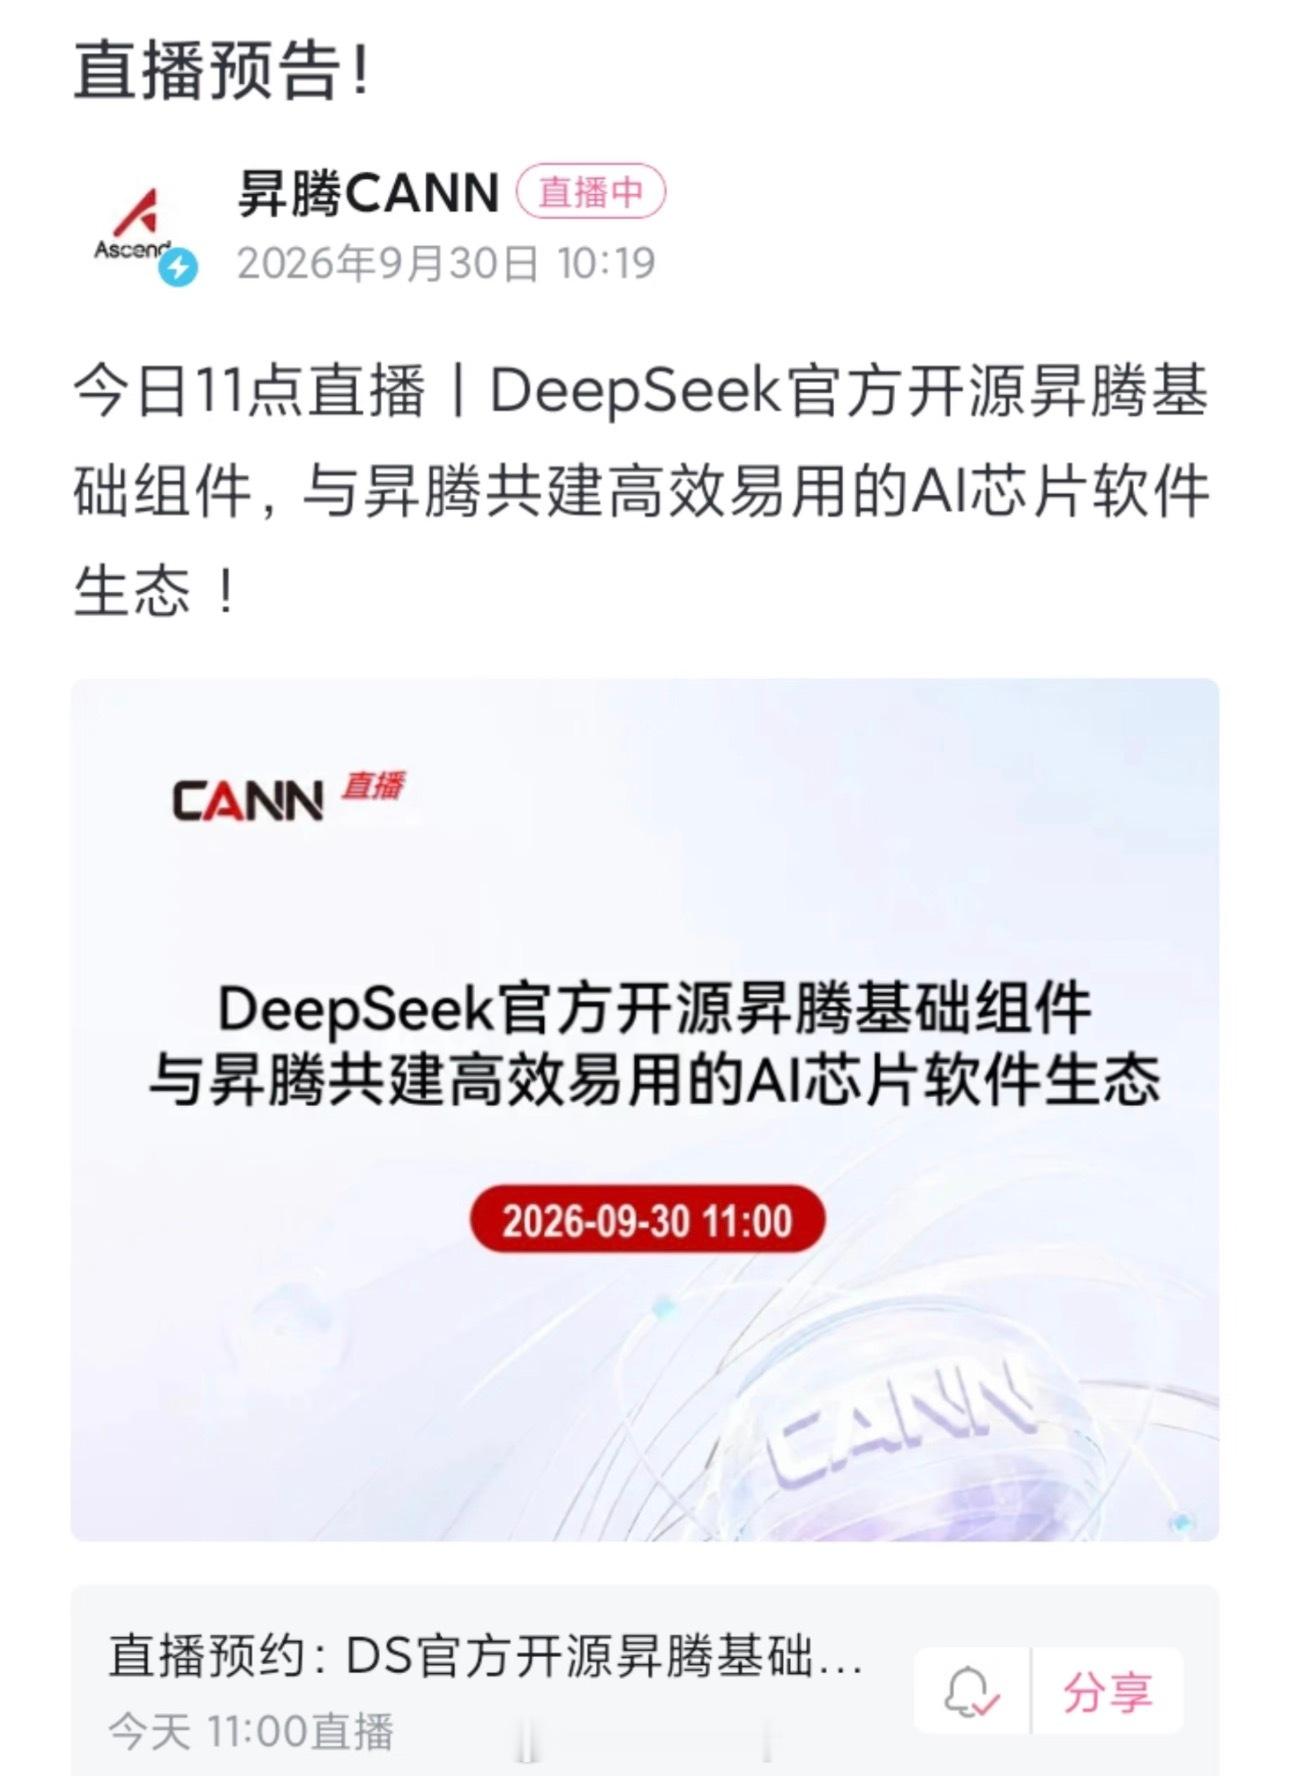
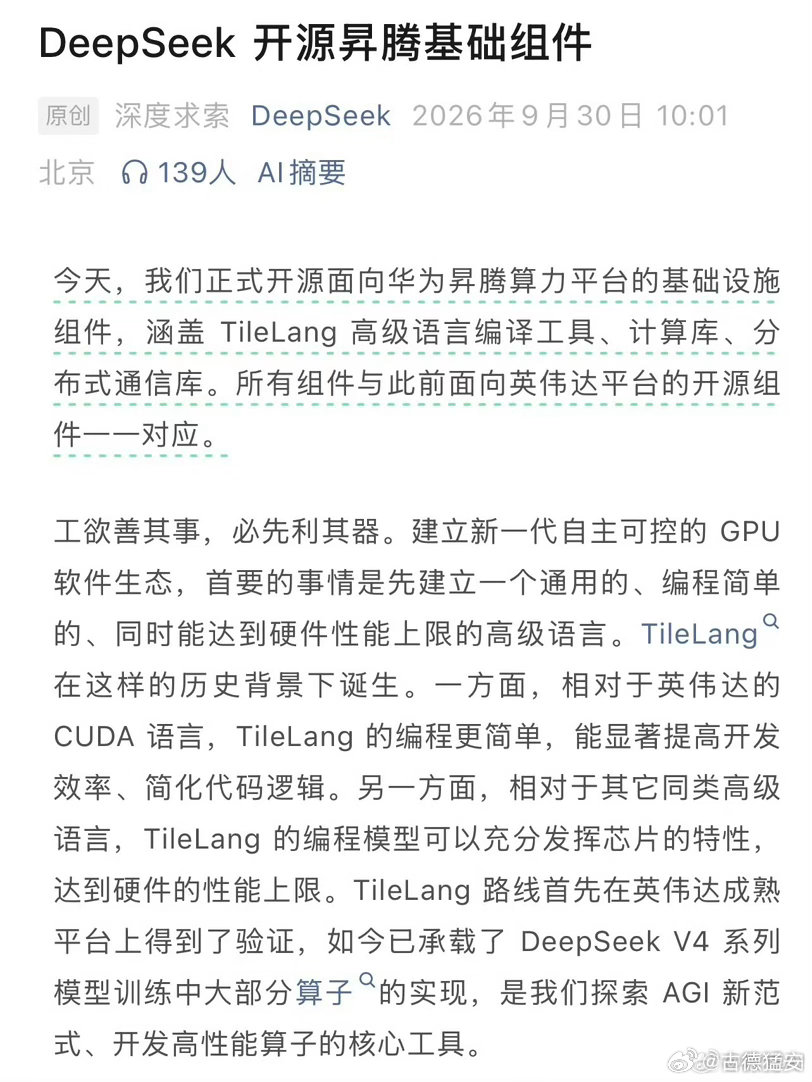
这回他们没发新模型,而是直接往国产算力的核爆点上扔了一颗重磅炸弹:正式开源了一整套面向华为昇腾的基础设施组件。简单一句话,就是把此前在英伟达平台上跑得飞起的那套核心底座,连根带叶、一刀未剪地搬进了华为昇腾的大院里。
熟悉国产算力的朋友都知道,过去国内芯片最痛的从来不是造不出卡,而是硬件出来了,配套的软件栈难用得让人想去砸墙。
英伟达最硬的护城河从来不是GPU硬件本身,而是打磨了二十年的CUDA生态。过去开发者想把昇腾的性能吃满,得捏着鼻子硬写极其底层的 Ascend C 代码,不仅痛苦,换一套芯片还得全部推翻重来。
而这次 DeepSeek 开源的“全家桶”,包括 TileLang、DeepGEMM、DeepEP、TileKernels、FlashMLA 和 DeepSelect,直接把大模型训练最核心的底层能力给齐活了。
这里面最狠的杀招,就是 TileLang。
如果说写底层算子就像是用汇编语言造火箭,那 TileLang 就是给开发者发了一套“用接近 Python 语法写高级算子”的降维武器。
它不仅让你写得爽,还能直接把代码编译到英伟达、AMD和华为昇腾等不同硬件上。
有点像大家熟知的 Triton,但 DeepSeek 从第一天起就没打算吊死在某一家硬件树上。
更关键的是,DeepSeek V4 系列训练里的核心算子已经全面用 TileLang 实现,这次昇腾版本直接把底层 Ascend C 封装到位,训练用到的每一个算子,在昇腾上都有现成实现。
除了“好写”,DeepSeek 还展现了什么叫“工业级榨干”。
在刚开源的 DeepGEMM 仓库里,官方给出的部分 Dense GEMM 矩阵计算测试中,昇腾上的硬件利用率最高做到了理论上限的 99.8%。这个数据简直是在对着芯片物理极限贴脸输出——这已经不是简单的软件调优,这是拿着皮鞭在分子层面榨取最后一丝算力。
再加上搞定 MoE 大规模跨卡通信的 DeepEP、专攻稀疏注意力的 FlashMLA,以及这次顺带透露的——DeepSeek 已经和华为一起完成了 Ascend 950 的 128 卡超节点深度优化。
这意味着什么?
这意味着国产芯片集群不再是“一堆单卡凑在一起抓瞎”,而是真正做到了百卡同频、百卡同心。
科技界一直有个悖论:好软件是炼出来的,不是在办公室里规划出来的。过去国产算力生态迟迟拧不成一股绳,很大程度上是因为缺乏顶级的 AI 巨头愿意拿自己的生产环境去给国产硬件“开荒”。
现在,DeepSeek 用最顶级的实战集群把这条路趟平了。他们不仅自己踩完了所有的坑,还顺便把坑填平、铺上了柏油路,最后把收费站给拆了。
当真正打过硬仗的玩家开始把兵工厂里的瑞士军刀和重型火炮直接摆在公桌上,靠着生态壁垒躺着收费的时代,可能真的要变天了。