云霞资讯网

紫霞爱品科技的文章

《数据主权是数字时代基本权利》 智能体集中下线提醒我们:数据主权不是可有可无的技术话题,而是数字时代的基本权利。用户投入角色、对话、记忆和创作,不应因平台调整而归零。 豆包、千问、元宝几乎同时下线智能体,用户失去的不只是功能,还有长期形成的数字关系。平台有合规责任,用户也有资产权 ​
《数据主权是数字时代基本权利》 智能体集中下线提醒我们:数据主权不是可有可无的技术话题,而是数字时代的基本权利。用户投入角色、对话、记忆和创作,不应因平台调整而归零。 豆包、千问、元宝几乎同时下线智能体,用户失去的不只是功能,还有长期形成的数字关系。平台有合规责任,用户也有资产权 ​
《平台不能把伦理成本转嫁用户》 伦理成本不应只由用户承担。平台享受用户投入带来的活跃数据,也应在服务调整时承担相应责任。 豆包、千问、元宝几乎同时下线智能体,用户失去角色、对话和记忆。平台可以解释合规压力,但用户损失并不因此消失。 真正负责任的平台,应在产品设计阶段就预留退出成本 ​

《平台不能把伦理成本转嫁用户》 伦理成本不应只由用户承担。平台享受用户投入带来的活跃数据,也应在服务调整时承担相应责任。 豆包、千问、元宝几乎同时下线智能体,用户失去角色、对话和记忆。平台可以解释合规压力,但用户损失并不因此消失。 真正负责任的平台,应在产品设计阶段就预留退出成本 ​
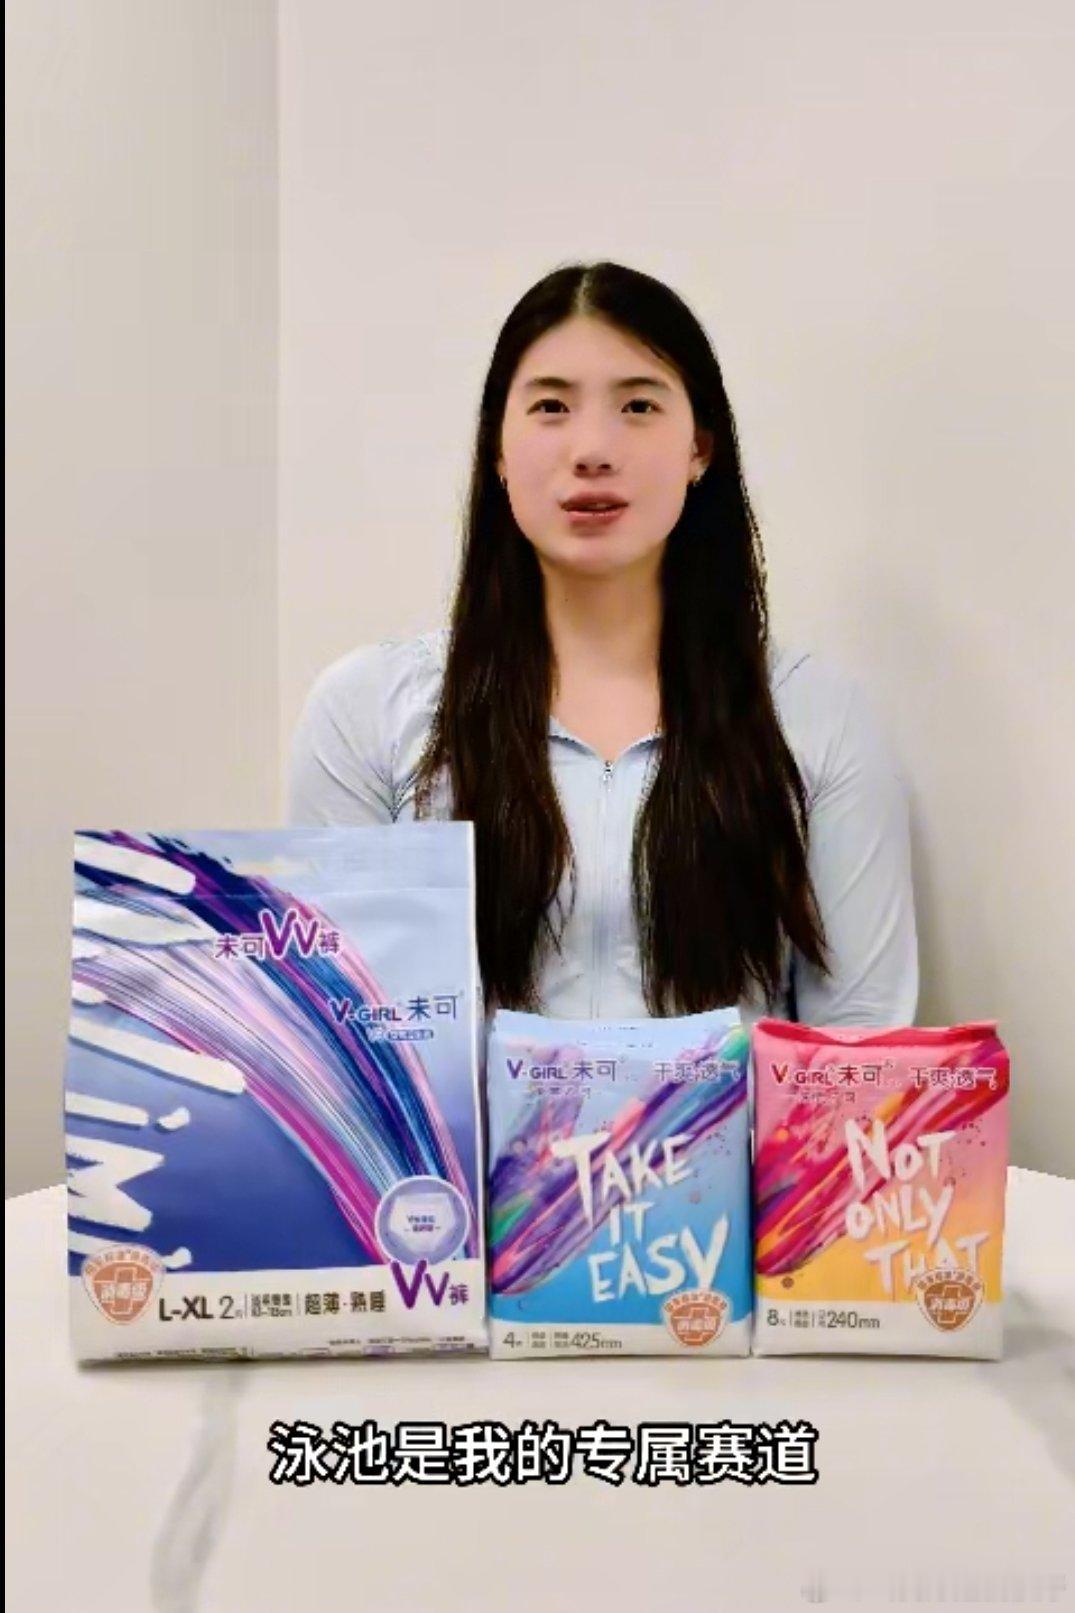
#未可为每一位女生喝彩# 
在本届名古屋亚运会上,有三位不同年龄段的女子选手闪耀在各自赛场——28岁第四次征战亚运的张雨霏在游泳赛场以四金完美收官,26岁第二次征战亚运的王祉怡在羽毛球赛场是中国女团重夺桂冠最值得信赖的一单,18岁第一次征战田径赛场的严子怡打破亚运纪录一投惊人。我们看到的是 ​

#未可为每一位女生喝彩# 在本届名古屋亚运会上,有三位不同年龄段的女子选手闪耀在各自赛场——28岁第四次征战亚运的张雨霏在游泳赛场以四金完美收官,26岁第二次征战亚运的王祉怡在羽毛球赛场是中国女团重夺桂冠最值得信赖的一单,18岁第一次征战田径赛场的严子怡打破亚运纪录一投惊人。我们看到的是 ​

#未可为每一位女生喝彩# 在本届名古屋亚运会上,有三位不同年龄段的女子选手闪耀在各自赛场——28岁第四次征战亚运的张雨霏在游泳赛场以四金完美收官,26岁第二次征战亚运的王祉怡在羽毛球赛场是中国女团重夺桂冠最值得信赖的一单,18岁第一次征战田径赛场的严子怡打破亚运纪录一投惊人。我们看到的是 ​
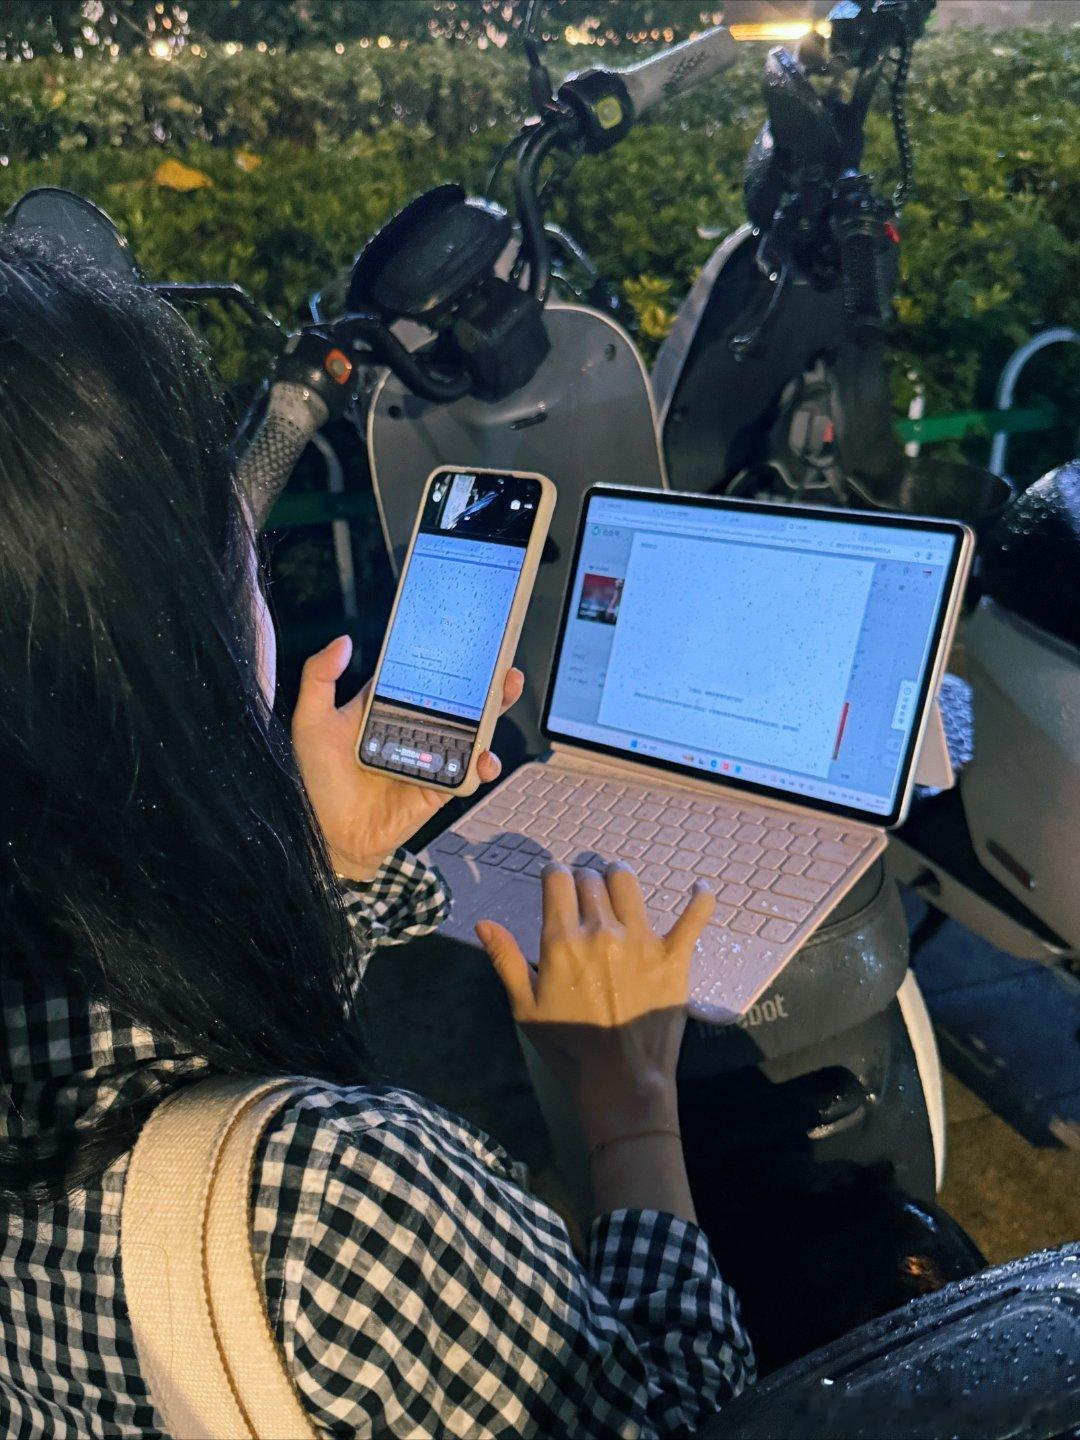
上海雨夜网约车里电动车旁的新闻女工[呵呵]
明天不能这么蓬头垢面了[苦涩]  ​

上海雨夜网约车里电动车旁的新闻女工[呵呵] 明天不能这么蓬头垢面了[苦涩] ​

上海雨夜网约车里电动车旁的新闻女工[呵呵] 明天不能这么蓬头垢面了[苦涩] ​
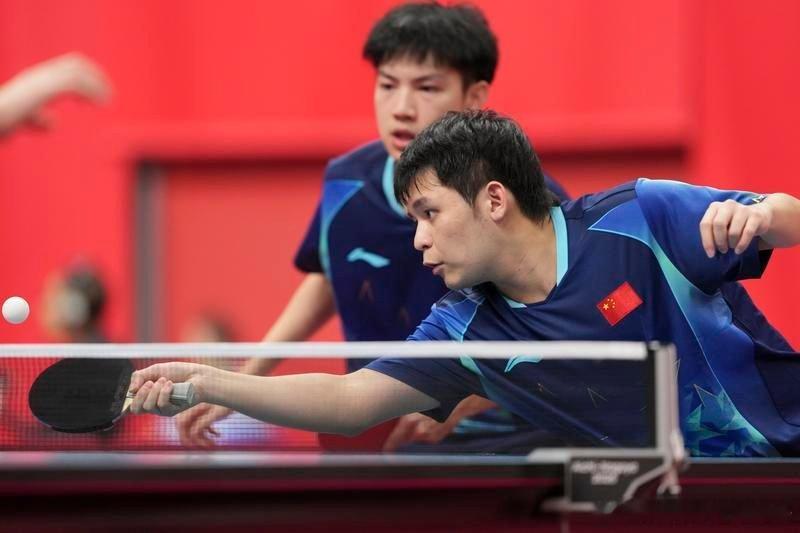
#乒乓球##亚运会乒乓球男双决赛# #黄友政林诗栋金牌#
恭喜黄友政/林诗栋半决赛决赛接连逆转两对日本组合夺冠!打得非常好!希望男团的失利就这样化作一次次的动力和胜利,让大家得到快速的成长! ​

#乒乓球##亚运会乒乓球男双决赛# #黄友政林诗栋金牌# 恭喜黄友政/林诗栋半决赛决赛接连逆转两对日本组合夺冠!打得非常好!希望男团的失利就这样化作一次次的动力和胜利,让大家得到快速的成长! ​

#乒乓球##亚运会乒乓球男双决赛# #黄友政林诗栋金牌# 恭喜黄友政/林诗栋半决赛决赛接连逆转两对日本组合夺冠!打得非常好!希望男团的失利就这样化作一次次的动力和胜利,让大家得到快速的成长! ​
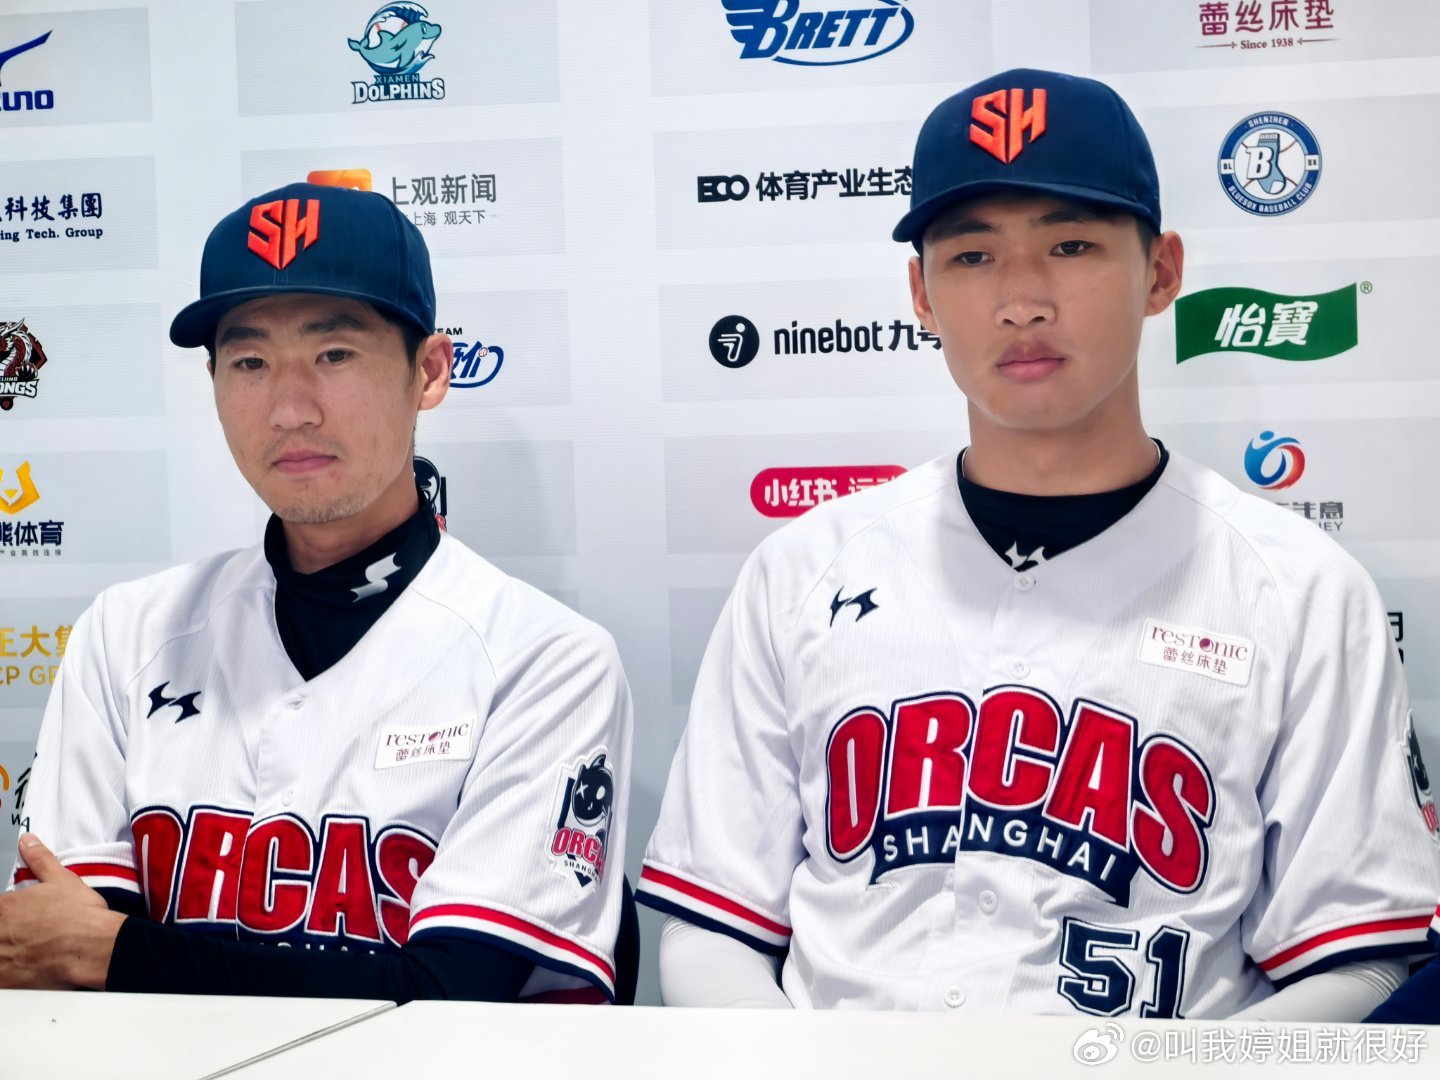
会提问的记者,就算不那么了解一个项目,也能问出好的问题,比如我问北京正大龙的古巴主教练怎么来融合这样一支语言、文化、打法不同的国际化队伍。

答:你的问题很有趣,主教练的位置不仅仅是指导技战术,更是要处理好不用国籍球员的关系,比如。。。我从来没想过这么几种不同文化碰撞一起,大家能成 ​

会提问的记者,就算不那么了解一个项目,也能问出好的问题,比如我问北京正大龙的古巴主教练怎么来融合这样一支语言、文化、打法不同的国际化队伍。 答:你的问题很有趣,主教练的位置不仅仅是指导技战术,更是要处理好不用国籍球员的关系,比如。。。我从来没想过这么几种不同文化碰撞一起,大家能成 ​

会提问的记者,就算不那么了解一个项目,也能问出好的问题,比如我问北京正大龙的古巴主教练怎么来融合这样一支语言、文化、打法不同的国际化队伍。 答:你的问题很有趣,主教练的位置不仅仅是指导技战术,更是要处理好不用国籍球员的关系,比如。。。我从来没想过这么几种不同文化碰撞一起,大家能成 ​

审核成本在总成本里排第几? 大模型全生命周期成本构成:训练算力35%-45%,推理算力30%-40%,数据获取与处理10%-15%,人力与研发8%-12%,基础设施与折旧3%-5%。审核成本在哪?它被包含在"数据获取与处理"或者"人力与研发"里,连单独列出来的资格都没有。连5%都不到的成本项,被拿来当砍功能的理由。这 ​

审核成本在总成本里排第几? 大模型全生命周期成本构成:训练算力35%-45%,推理算力30%-40%,数据获取与处理10%-15%,人力与研发8%-12%,基础设施与折旧3%-5%。审核成本在哪?它被包含在"数据获取与处理"或者"人力与研发"里,连单独列出来的资格都没有。连5%都不到的成本项,被拿来当砍功能的理由。这 ​

开源模型让成本暴跌 2026年开源模型体系已经非常成熟,7B模型在特定场景下可以匹配72B模型的性能,VRAM需求从140GB降到14GB,单卡RTX 4090就能跑。美团LocalGPT的研究证明了这一点。开源+微调+领域专用,成本可以降到原来的1/10。大厂有开源模型不用,非要拿"算力成本高"当借口,为什么?因为开源意味 ​

开源模型让成本暴跌 2026年开源模型体系已经非常成熟,7B模型在特定场景下可以匹配72B模型的性能,VRAM需求从140GB降到14GB,单卡RTX 4090就能跑。美团LocalGPT的研究证明了这一点。开源+微调+领域专用,成本可以降到原来的1/10。大厂有开源模型不用,非要拿"算力成本高"当借口,为什么?因为开源意味 ​

DeepSeek-V3训练成本557万美元 DeepSeek-V3训练成本557.6万美元,使用2048块H800 GPU,累计278.8万GPU小时。得益于MoE架构、FP8训练及动态批处理等技术优化。557万美元是什么概念?约4000万人民币。对于一个V3级别的大模型,4000万训练成本。然后大厂说"算力成本太高"。4000万对于一家融资几十亿的AI ​

DeepSeek-V3训练成本557万美元 DeepSeek-V3训练成本557.6万美元,使用2048块H800 GPU,累计278.8万GPU小时。得益于MoE架构、FP8训练及动态批处理等技术优化。557万美元是什么概念?约4000万人民币。对于一个V3级别的大模型,4000万训练成本。然后大厂说"算力成本太高"。4000万对于一家融资几十亿的AI ​

#豆包转型坐实侵权[超话]##反对豆包智能体一刀切下架[超话]##豆包智能体记忆主权[超话]##字节旗下豆包一刀切下架智能体[超话]#行业每1元营收对应1.6-2.25元成本 AI行业整体每1元营收背后约对应1.6至2.25元刚性成本。OpenAI 2025年营收131亿美元,现金亏损80亿美元。智谱AI 2025年研发开支31.8亿元,为 ​

#豆包转型坐实侵权[超话]##反对豆包智能体一刀切下架[超话]##豆包智能体记忆主权[超话]##字节旗下豆包一刀切下架智能体[超话]#行业每1元营收对应1.6-2.25元成本 AI行业整体每1元营收背后约对应1.6至2.25元刚性成本。OpenAI 2025年营收131亿美元,现金亏损80亿美元。智谱AI 2025年研发开支31.8亿元,为 ​

Token Factory毛利率60% 中金公司测算,在自建算力情景下,Token Factory的理论毛利率可达到60%。海外头部模型厂商业务毛利率已达40%-50%。60%的毛利率啊朋友们,这比茅台还暴利。然后大厂跟你说"算力成本太高所以功能要下线"。60%毛利率叫"成本太高",那什么叫成本低?做慈善吗?这就像开餐厅的跟你 ​

Token Factory毛利率60% 中金公司测算,在自建算力情景下,Token Factory的理论毛利率可达到60%。海外头部模型厂商业务毛利率已达40%-50%。60%的毛利率啊朋友们,这比茅台还暴利。然后大厂跟你说"算力成本太高所以功能要下线"。60%毛利率叫"成本太高",那什么叫成本低?做慈善吗?这就像开餐厅的跟你 ​

国产模型价格只有海外1/6 智谱GLM-5.1输出价格4.4美元/百万Tokens,Claude Opus 4.7是25美元/百万Tokens。国产模型价格基本是海外的1/6甚至更低。为什么?因为国内模型参数规模小、激活参数量少、工程优化更极致。MiniMax的M3模型在百万上下文规模下,单Token计算量是上一代的1/20。成本在降,价格在 ​

国产模型价格只有海外1/6 智谱GLM-5.1输出价格4.4美元/百万Tokens,Claude Opus 4.7是25美元/百万Tokens。国产模型价格基本是海外的1/6甚至更低。为什么?因为国内模型参数规模小、激活参数量少、工程优化更极致。MiniMax的M3模型在百万上下文规模下,单Token计算量是上一代的1/20。成本在降,价格在 ​

电费到底占几成? "AI算力成本里60%-70%都是电费"——这句话被传得满天飞。但沐曦股份的CTO亲自出来辟谣:那说的是运营阶段的运维费用占比,不是全生命周期成本。一座投资15亿的万卡级智算中心,电费加运维在整个投入里占比不超过20%。所以大厂拿"电费太贵"当理由砍功能,就像餐厅说"我们水费太贵所以 ​

电费到底占几成? "AI算力成本里60%-70%都是电费"——这句话被传得满天飞。但沐曦股份的CTO亲自出来辟谣:那说的是运营阶段的运维费用占比,不是全生命周期成本。一座投资15亿的万卡级智算中心,电费加运维在整个投入里占比不超过20%。所以大厂拿"电费太贵"当理由砍功能,就像餐厅说"我们水费太贵所以 ​

训练vs推理,谁在烧钱? 有人会说训练模型贵啊,千亿参数模型训练一次几千万上亿。没错,但训练是一次性投入。推理才是持续出血口——GPT-4两年推理成本是训练的15倍,约23亿美元。推理成本随用户量线性增长,这才是真正的"成本黑洞"。所以大厂砍功能,不是因为训练贵,是因为用户用得太多了。翻译一 ​

训练vs推理,谁在烧钱? 有人会说训练模型贵啊,千亿参数模型训练一次几千万上亿。没错,但训练是一次性投入。推理才是持续出血口——GPT-4两年推理成本是训练的15倍,约23亿美元。推理成本随用户量线性增长,这才是真正的"成本黑洞"。所以大厂砍功能,不是因为训练贵,是因为用户用得太多了。翻译一 ​

成本与价格的剪刀差 国产模型价格只有海外1/6,Token Factory毛利率60%,推理成本每年降10倍。成本在降,价格在降,毛利率在升。那用户得到的好处呢?功能被砍了。成本下降的红利,用户没分到;成本上升的借口,用户全承担了。这就好比餐厅食材价格降了50%,厨师工资降了30%,然后老板说"因为成本太高 ​

成本与价格的剪刀差 国产模型价格只有海外1/6,Token Factory毛利率60%,推理成本每年降10倍。成本在降,价格在降,毛利率在升。那用户得到的好处呢?功能被砍了。成本下降的红利,用户没分到;成本上升的借口,用户全承担了。这就好比餐厅食材价格降了50%,厨师工资降了30%,然后老板说"因为成本太高 ​

迁移成本被忽略 跨云厂商、跨区域部署时的数据迁移、接口适配与兼容性测试成本——这叫迁移成本。大厂在不同云平台之间迁来迁去,每次迁移都烧钱。这钱花得值不值?也许值,也许不值。但关键是:迁移成本是厂商自己的选择,不是用户造成的。用户什么都没做,就坐在家里点了个按钮,然后厂商说"因为你 ​

迁移成本被忽略 跨云厂商、跨区域部署时的数据迁移、接口适配与兼容性测试成本——这叫迁移成本。大厂在不同云平台之间迁来迁去,每次迁移都烧钱。这钱花得值不值?也许值,也许不值。但关键是:迁移成本是厂商自己的选择,不是用户造成的。用户什么都没做,就坐在家里点了个按钮,然后厂商说"因为你 ​

试错成本是成功训练的3-5倍 模型迭代中的训练失败、超参数调优等实验损耗使实际研发成本达到单次成功训练成本的3-5倍。3-5倍。这意味着每成功一次,要失败3-5次。这3-5次失败的成本,是研发效率问题,不是用户功能问题。砍用户功能能减少训练失败次数吗?不能。所以砍功能跟试错成本也没关系。大厂把 ​

试错成本是成功训练的3-5倍 模型迭代中的训练失败、超参数调优等实验损耗使实际研发成本达到单次成功训练成本的3-5倍。3-5倍。这意味着每成功一次,要失败3-5次。这3-5次失败的成本,是研发效率问题,不是用户功能问题。砍用户功能能减少训练失败次数吗?不能。所以砍功能跟试错成本也没关系。大厂把 ​

算力成本总结 算力成本占35%-45%且在下降,单次推理成本约一厘钱,推理成本每年降10倍,国产模型价格只有海外1/6,Token Factory毛利率60%,开源模型让成本再降10倍。综合下来,"算力成本太高"这个理由,经不起任何角度的推敲。它不是事实,它是话术。真正的原因,大厂不会告诉你,但数据会。 ​

算力成本总结 算力成本占35%-45%且在下降,单次推理成本约一厘钱,推理成本每年降10倍,国产模型价格只有海外1/6,Token Factory毛利率60%,开源模型让成本再降10倍。综合下来,"算力成本太高"这个理由,经不起任何角度的推敲。它不是事实,它是话术。真正的原因,大厂不会告诉你,但数据会。 ​

DeepSeek-V3训练成本557万美元 DeepSeek-V3训练成本557.6万美元,使用2048块H800 GPU,累计278.8万GPU小时。得益于MoE架构、FP8训练及动态批处理等技术优化。557万美元是什么概念?约4000万人民币。对于一个V3级别的大模型,4000万训练成本。然后大厂说"算力成本太高"。4000万对于一家融资几十亿的AI ​

DeepSeek-V3训练成本557万美元 DeepSeek-V3训练成本557.6万美元,使用2048块H800 GPU,累计278.8万GPU小时。得益于MoE架构、FP8训练及动态批处理等技术优化。557万美元是什么概念?约4000万人民币。对于一个V3级别的大模型,4000万训练成本。然后大厂说"算力成本太高"。4000万对于一家融资几十亿的AI ​

算力成本占比逐年下降 2025年以前,算力成本在大模型总成本中占比通常超过50%。到2026年,随着开源模型体系成熟与模型压缩等技术进步,该占比已下降至35%-45%。趋势是什么?算力成本占比在下降。那大厂砍功能是因为"算力成本太高"?不对,算力成本占比在逐年降低。真正在涨的是什么?人力、研发、数据 ​

算力成本占比逐年下降 2025年以前,算力成本在大模型总成本中占比通常超过50%。到2026年,随着开源模型体系成熟与模型压缩等技术进步,该占比已下降至35%-45%。趋势是什么?算力成本占比在下降。那大厂砍功能是因为"算力成本太高"?不对,算力成本占比在逐年降低。真正在涨的是什么?人力、研发、数据 ​