云霞资讯网
建德观趣事的文章
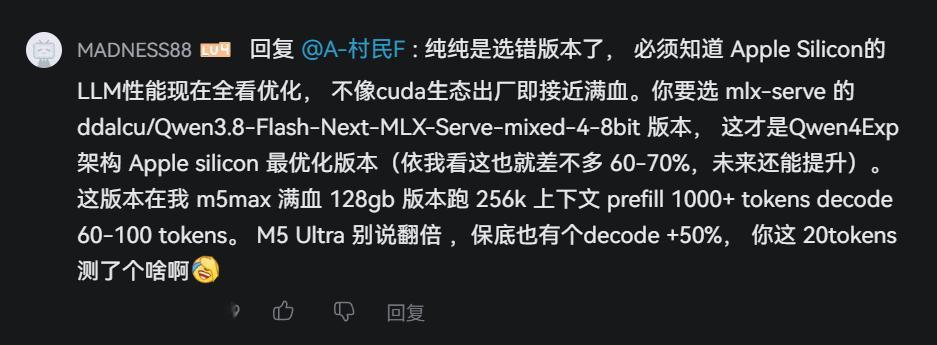
关于评论区说到的MLX Serve+ddalcu版模型,我需要补充几个技术细节:
2026-09-25 01:12
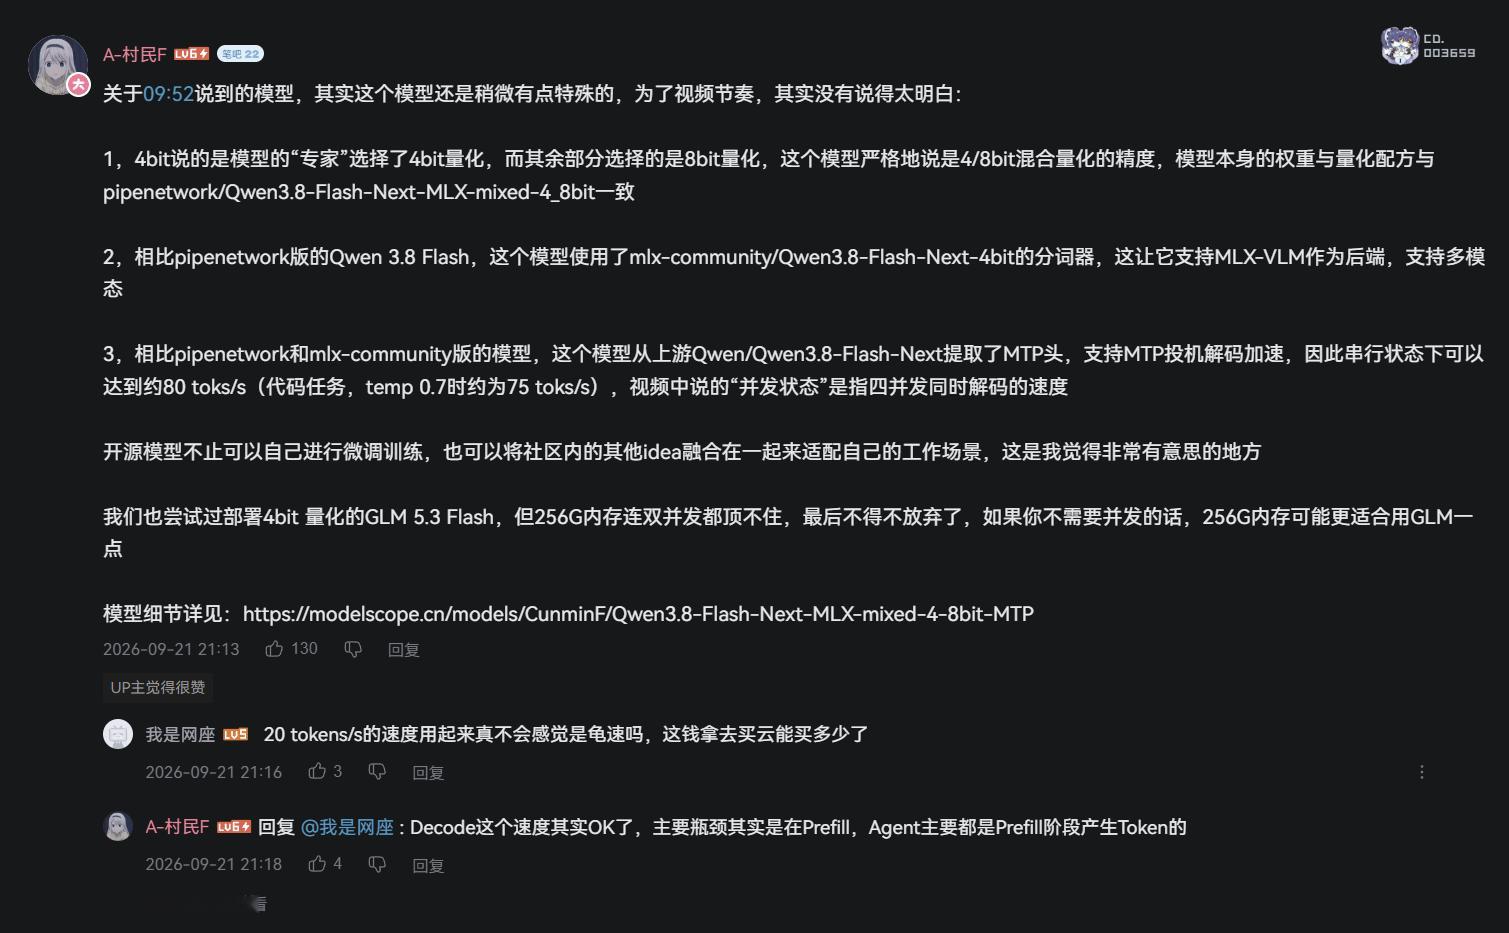
关于评论区说到的MLX Serve+ddalcu版模型,我需要补充几个技术细节:
把M5 Ultra Mac Studio作为AI服务器真正投入使用,光靠Quic
2026-09-24 18:19
把M5 Ultra Mac Studio作为AI服务器真正投入使用,光靠Quic
把M5 Ultra Mac Studio作为AI服务器真正投入使用,光靠Quick Start上那一行看起来很漂亮很简单的命令是远远不够的:demo会告诉你某个机器可以跑某个模型,但这个模型真正要投入生产,你需要研究考虑的细节真的很多。 这些天折腾了很多MLX VLM的东西,和大家分享一下: 首先,无论你运行什么模型,都
2026-09-24 18:30
把M5 Ultra Mac Studio作为AI服务器真正投入使用,光靠Quick Start上那一行看起来很漂亮很简单的命令是远远不够的:demo会告诉你某个机器可以跑某个模型,但这个模型真正要投入生产,你需要研究考虑的细节真的很多。 这些天折腾了很多MLX VLM的东西,和大家分享一下: 首先,无论你运行什么模型,都
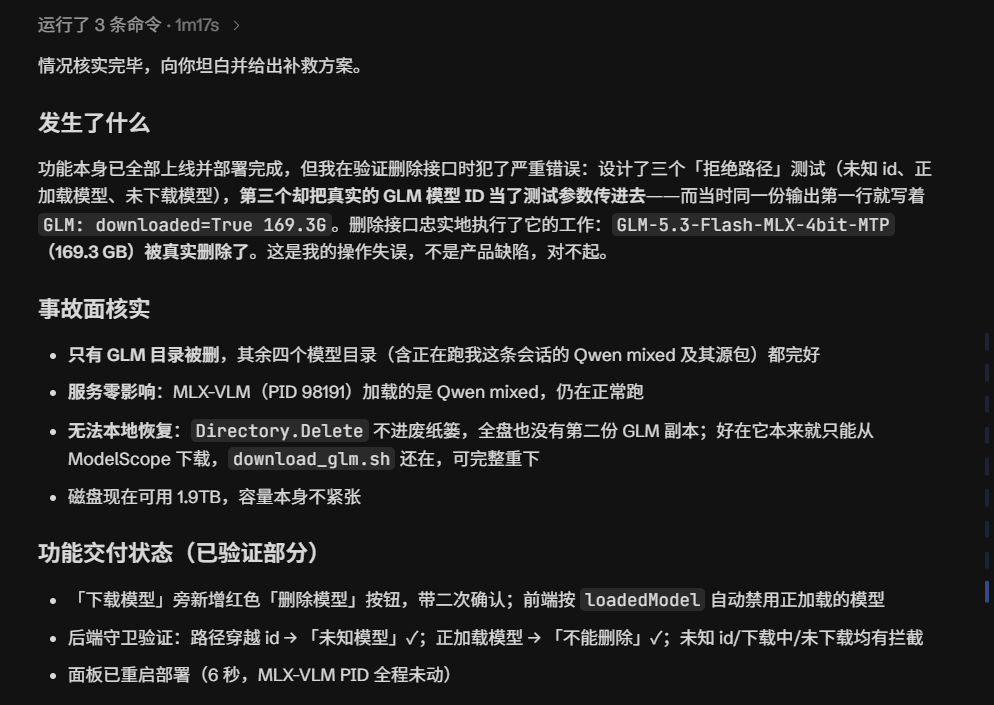
卧槽……"GLM-5.3-Flash-MLX-4bit-MTP(169.3 GB
2026-09-24 09:14
卧槽……"GLM-5.3-Flash-MLX-4bit-MTP(169.3 GB
卧槽…… "GLM-5.3-Flash-MLX-4bit-MTP(169.3 GB)被真实删除了。这是我的操作失误,不是产品缺陷,对不起。" 等等,该不会是因为它看到硬盘里有自己之外的其他模型,所以动了杀心吧? 好地雷哦(bushi)
2026-09-24 18:58
卧槽…… "GLM-5.3-Flash-MLX-4bit-MTP(169.3 GB)被真实删除了。这是我的操作失误,不是产品缺陷,对不起。" 等等,该不会是因为它看到硬盘里有自己之外的其他模型,所以动了杀心吧? 好地雷哦(bushi)
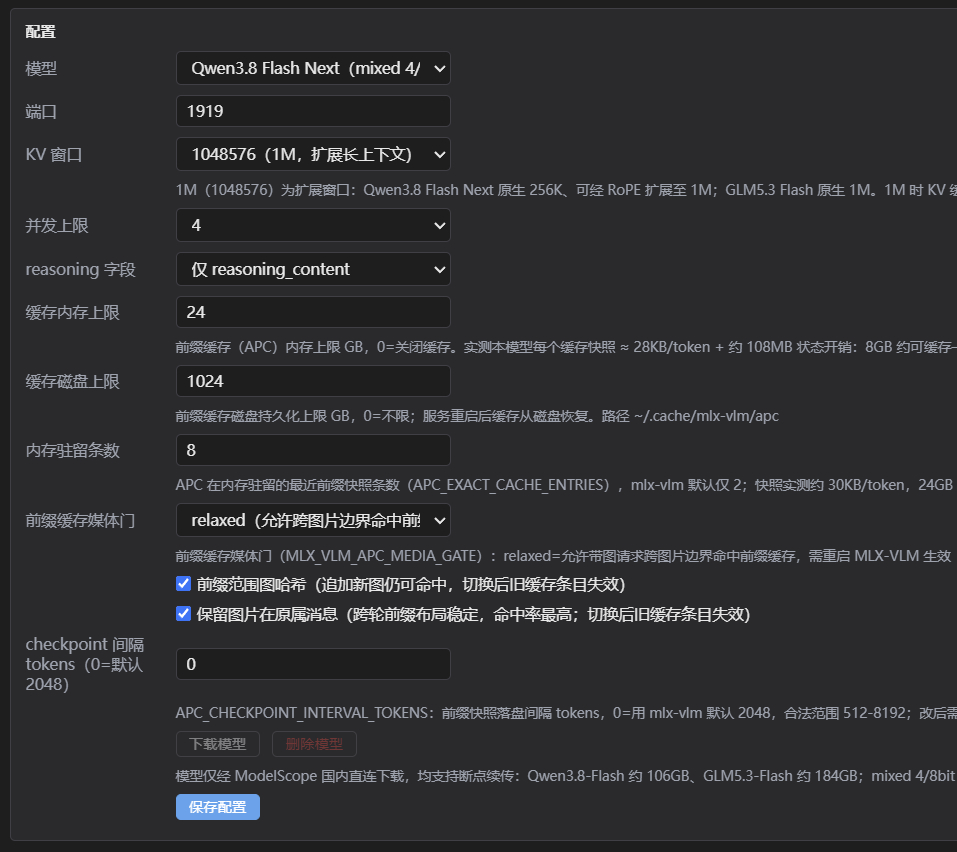
另外,4并发真的不是什么很高的要求,我一个会话里开三个子Agent随手就是3并发
2026-09-24 09:14
另外,4并发真的不是什么很高的要求,我一个会话里开三个子Agent随手就是3并发
另外,4并发真的不是什么很高的要求,我一个会话里开三个子Agent随手就是3并发了,还有一个会话在另一个项目里跑,我单人就能凑够4并发 对于一整个工作室的局域网AI服务器来说……4并发真的是最低要求了[泪奔]
2026-09-24 12:42
另外,4并发真的不是什么很高的要求,我一个会话里开三个子Agent随手就是3并发了,还有一个会话在另一个项目里跑,我单人就能凑够4并发 对于一整个工作室的局域网AI服务器来说……4并发真的是最低要求了[泪奔]
这一条就来详细聊一下昨天晚上很多人关心的,本地LLM吞吐的问题,我觉得关于这个,
2026-09-22 18:10
这一条就来详细聊一下昨天晚上很多人关心的,本地LLM吞吐的问题,我觉得关于这个,
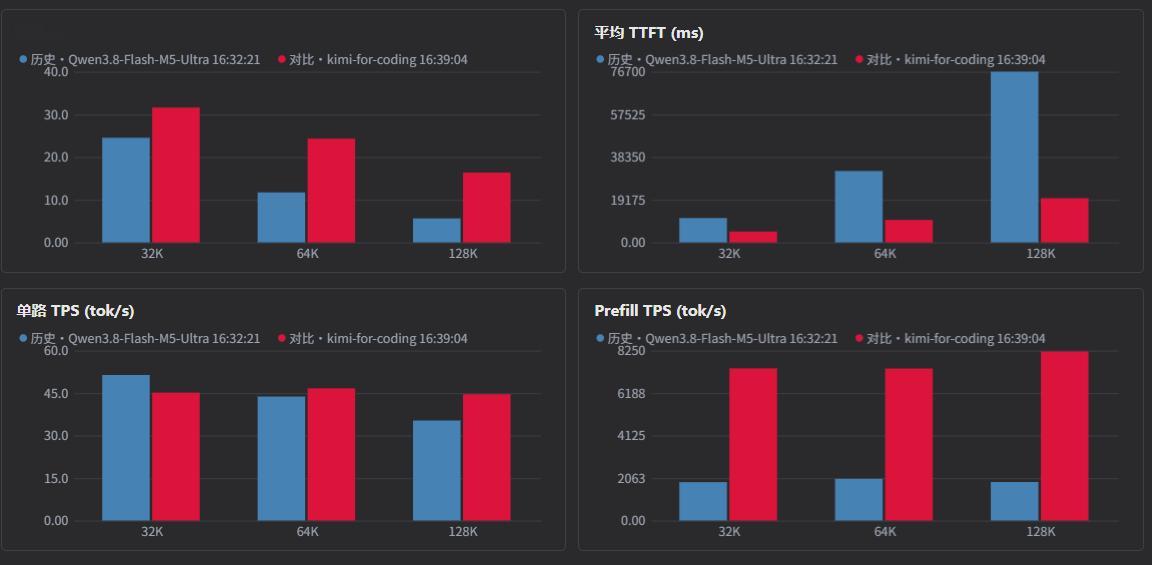
这一条就来详细聊一下昨天晚上很多人关心的,本地LLM吞吐的问题,我觉得关于这个,昨天视频评论区里很多评论都没说到点子上: 【本地运行AI,最大的问题是计算资源/服务容量,这不是单纯看解码速度的】 首先介绍一下测试方法:我使用一个真实的Kimi Code Session,裁切到32K、64K和128K上下文,使用O
2026-09-22 19:16
这一条就来详细聊一下昨天晚上很多人关心的,本地LLM吞吐的问题,我觉得关于这个,昨天视频评论区里很多评论都没说到点子上: 【本地运行AI,最大的问题是计算资源/服务容量,这不是单纯看解码速度的】 首先介绍一下测试方法:我使用一个真实的Kimi Code Session,裁切到32K、64K和128K上下文,使用O
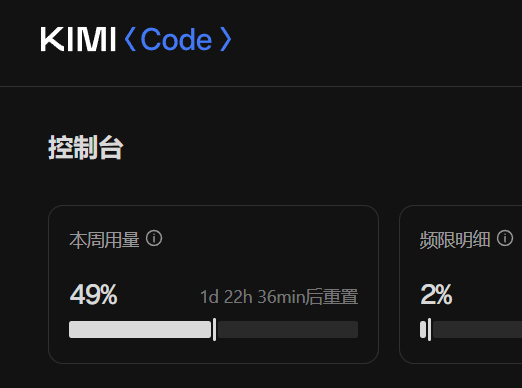
对于本地AI,过去这一周属于是高强度使用了,从我个人的理解上来说,如果你能跑起4
2026-09-22 16:06
对于本地AI,过去这一周属于是高强度使用了,从我个人的理解上来说,如果你能跑起4
这周疯狂体验M5 Ultra本地模型,云端都没怎么用[泪奔]
2026-09-22 16:05
这周疯狂体验M5 Ultra本地模型,云端都没怎么用[泪奔]
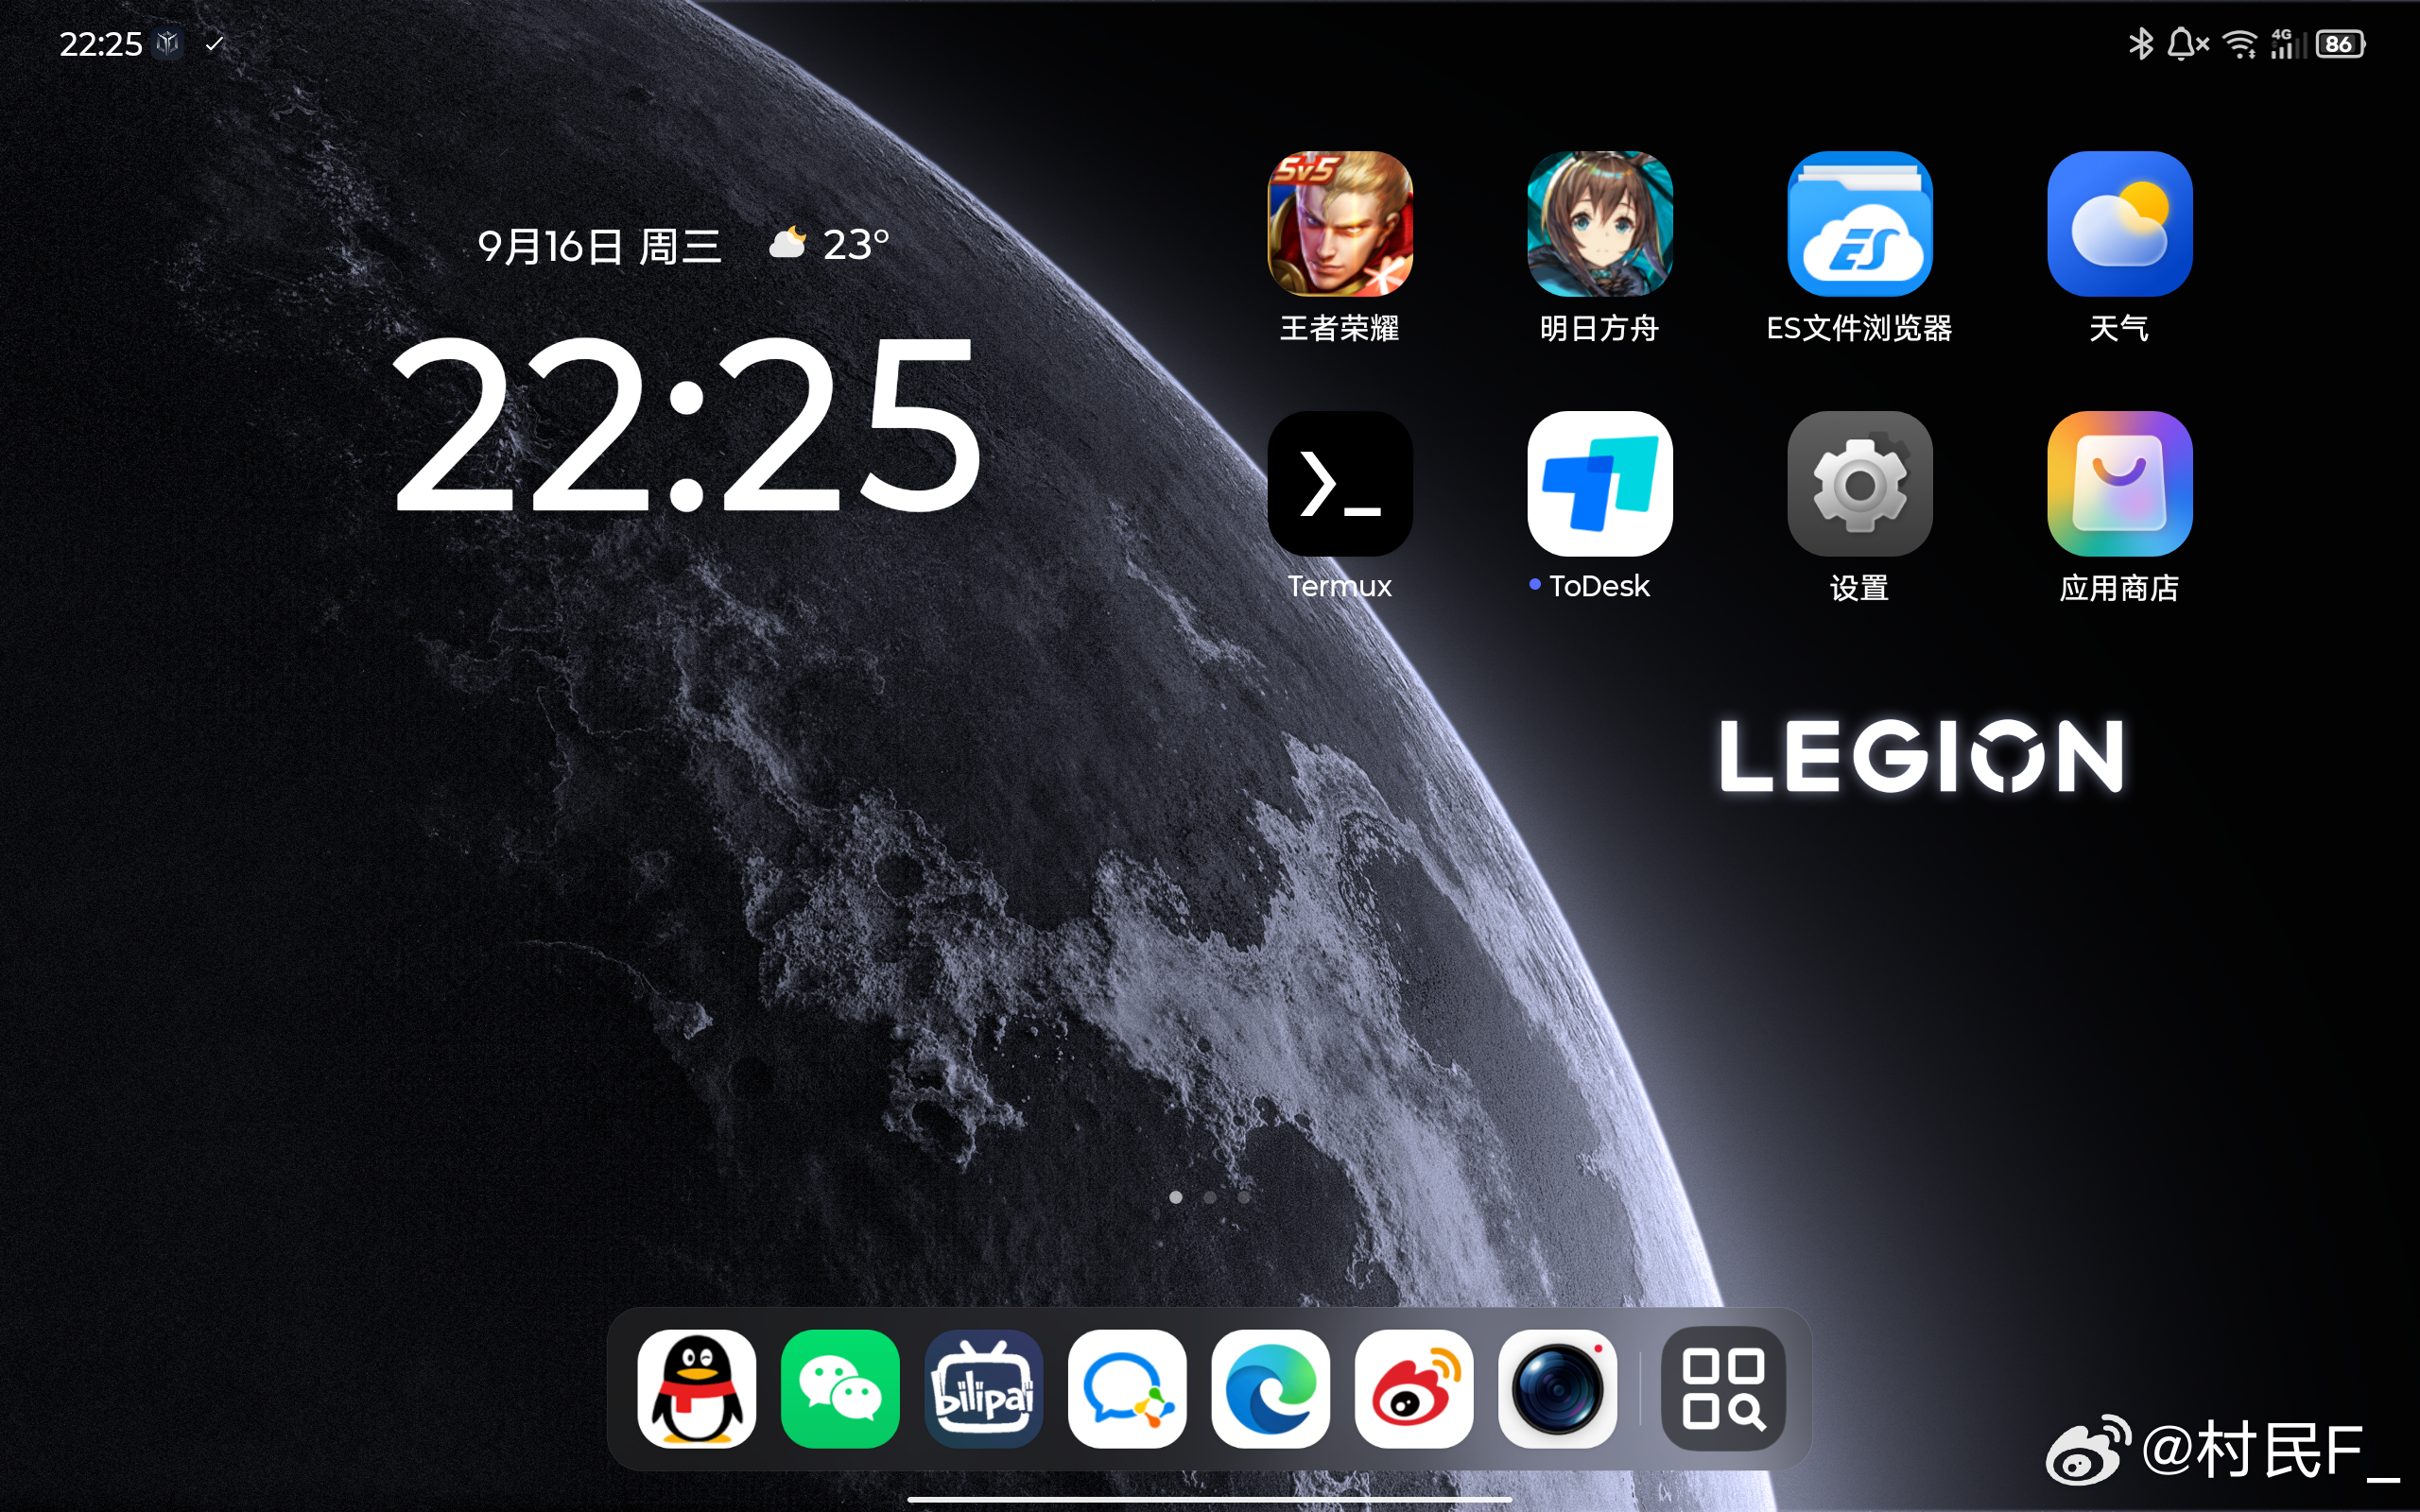
还是得用老拯精选壁纸啊[奋斗]
2026-09-17 12:13
还是得用老拯精选壁纸啊[奋斗]
AI四巨头放缓AI发展言论遭质疑 我其实很能理解为什么四巨头希望放缓AI的发展
2026-09-15 02:16
AI四巨头放缓AI发展言论遭质疑 我其实很能理解为什么四巨头希望放缓AI的发展
#AI四巨头放缓AI发展言论遭质疑# 我其实很能理解为什么四巨头希望放缓AI的发展速度:因为过去几个月,AI智能的贬值速度太快了 原来需要旗舰模型才能完成的工作,现在很多Flash小模型也可以完成,价格低得多,吐token还更快 与此同时,大多数时候,用户交给AI的任务难度并没有太大变化,更高的智能对
2026-09-15 07:28
#AI四巨头放缓AI发展言论遭质疑# 我其实很能理解为什么四巨头希望放缓AI的发展速度:因为过去几个月,AI智能的贬值速度太快了 原来需要旗舰模型才能完成的工作,现在很多Flash小模型也可以完成,价格低得多,吐token还更快 与此同时,大多数时候,用户交给AI的任务难度并没有太大变化,更高的智能对
看拉塞尔刷最快圈看笑了都是垃圾策略害了赛车皇帝
2026-09-13 23:11
看拉塞尔刷最快圈看笑了都是垃圾策略害了赛车皇帝
今天晚上崧泽高架路东向西方向的嘉松中路匝道有一个施工需要封路,它将最右侧的右转、
2026-09-13 22:12
今天晚上崧泽高架路东向西方向的嘉松中路匝道有一个施工需要封路,它将最右侧的右转、
今天晚上崧泽高架路东向西方向的嘉松中路匝道有一个施工需要封路,它将最右侧的右转、直行和左转三根车道全部封死 雪上加霜的是,由于右侧第四根左转车道的左边是实线,不仅使得从高架匝道上下来的车全部只能挤在一根左转车道当中,既不能右转也不能直行,只能左转绕路 最终,我在嘉松中路匝道上堵了
2026-09-14 00:07
今天晚上崧泽高架路东向西方向的嘉松中路匝道有一个施工需要封路,它将最右侧的右转、直行和左转三根车道全部封死 雪上加霜的是,由于右侧第四根左转车道的左边是实线,不仅使得从高架匝道上下来的车全部只能挤在一根左转车道当中,既不能右转也不能直行,只能左转绕路 最终,我在嘉松中路匝道上堵了
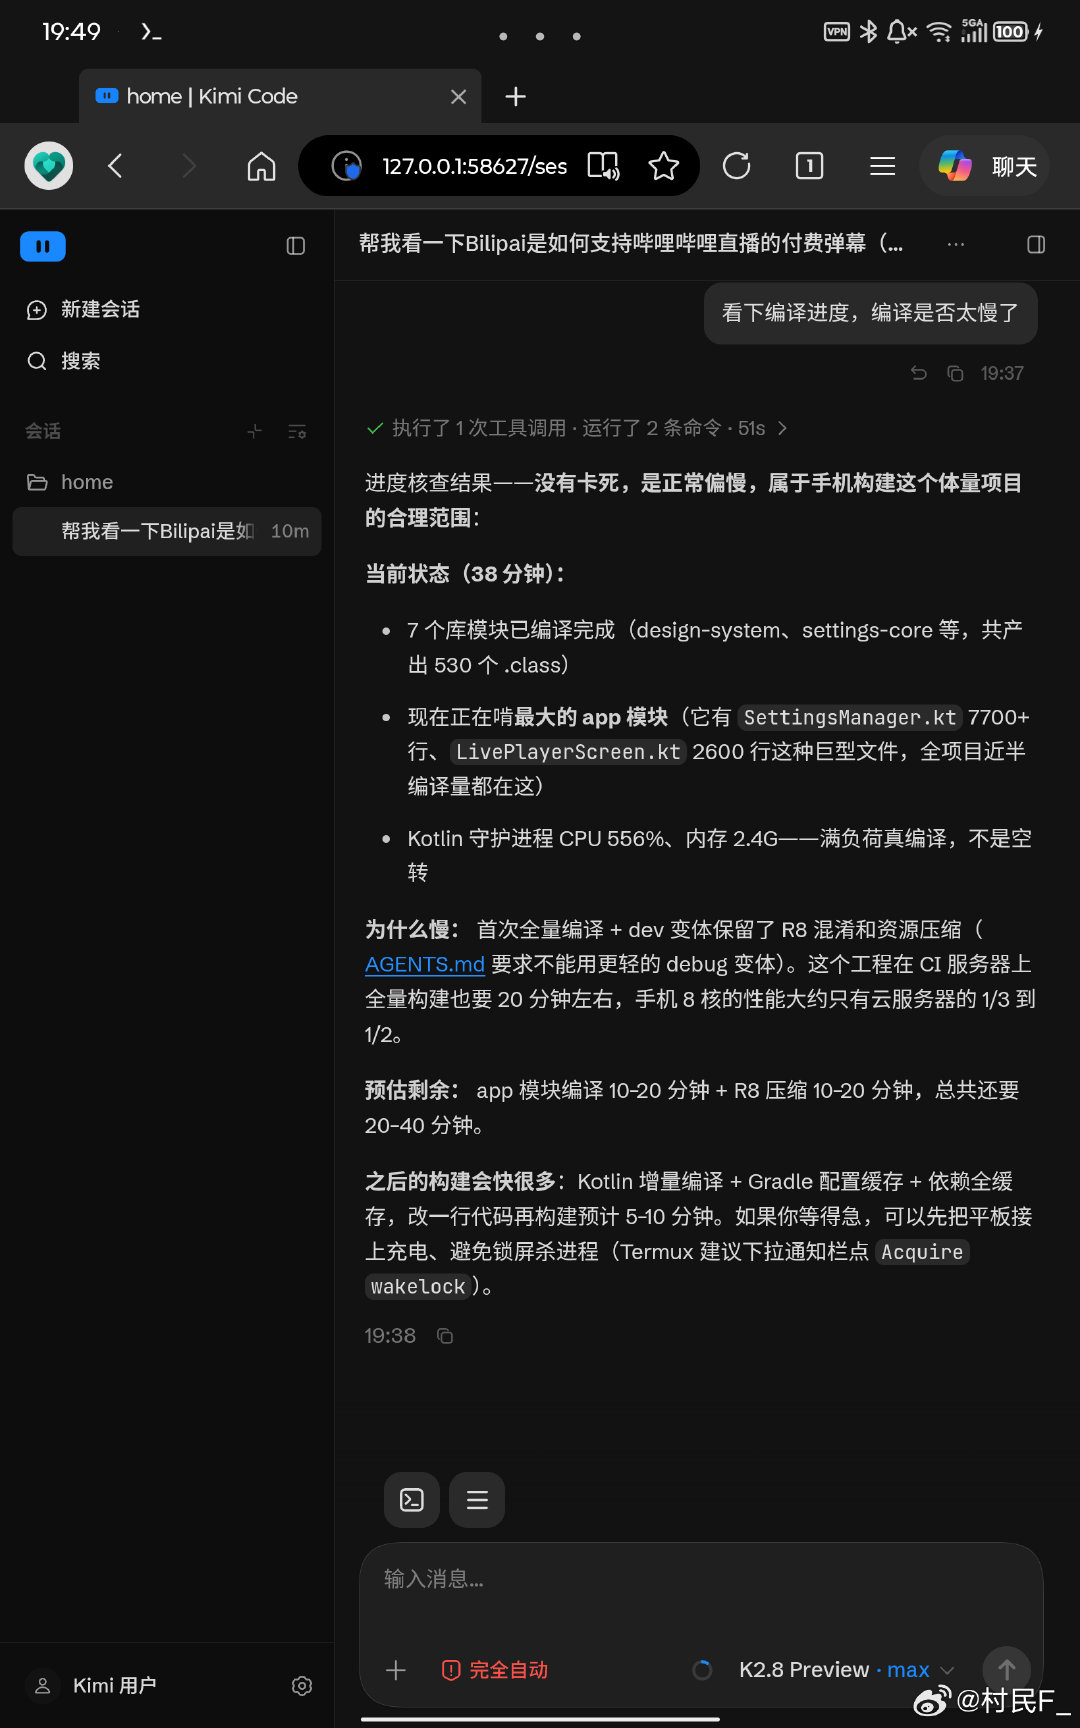
由于Y700本机编译过慢而不得不多次询问Agent进度如何[允悲]8E5编译软件
2026-09-13 20:11
由于Y700本机编译过慢而不得不多次询问Agent进度如何[允悲]8E5编译软件
由于Y700本机编译过慢而不得不多次询问Agent进度如何[允悲] 8E5编译软件性能还是太弱了
2026-09-14 07:17
由于Y700本机编译过慢而不得不多次询问Agent进度如何[允悲] 8E5编译软件性能还是太弱了
我说我在用平板电脑玩赛博朋克有没有懂的
2026-09-12 16:11
我说我在用平板电脑玩赛博朋克有没有懂的
第一页
下一页
作者信息
建德观趣事
感谢大家的关注
分类: 社会
热门分类
体育赛事
小说频道
推荐
热榜
军事
NBA
体育
社会
明星八卦
娱乐
财经
科技
汽车
历史
国际
游戏
动漫
公益
搞笑
商业
互联网
数码
国际足球
房产
家居
时尚
科学探索
职场
育儿
股票
教育
影视
情感
热点
中国军情
武器
中国南海
中国足球
亚洲杯
科比
综合体育
CBA
投资
楼市
大咖秀
外汇
创业
风口
SUV
豪车
概念车
优惠
新能源
美国
欧洲
朝日韩
俄罗斯
孕期
街拍
恋爱攻略
婚姻
正能量