权重装进了,长请求呢?
🧮 模型权重加载了,短问题也能回答,就能承诺四路32K长上下文吗?先算剩下的空间,不看“已加载”三个字。
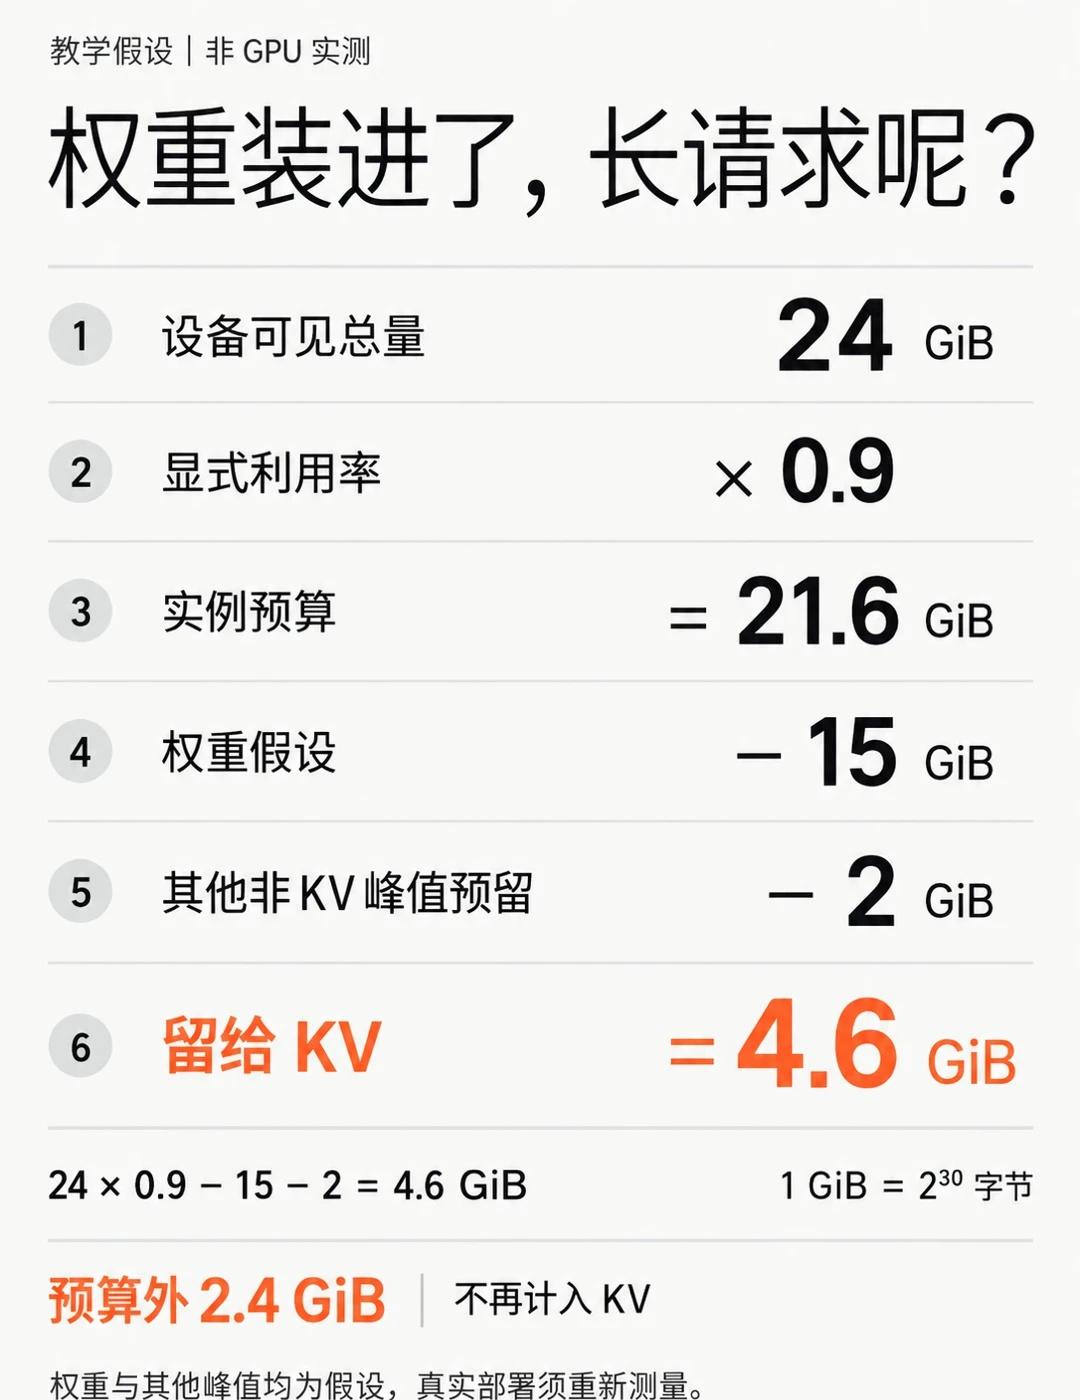
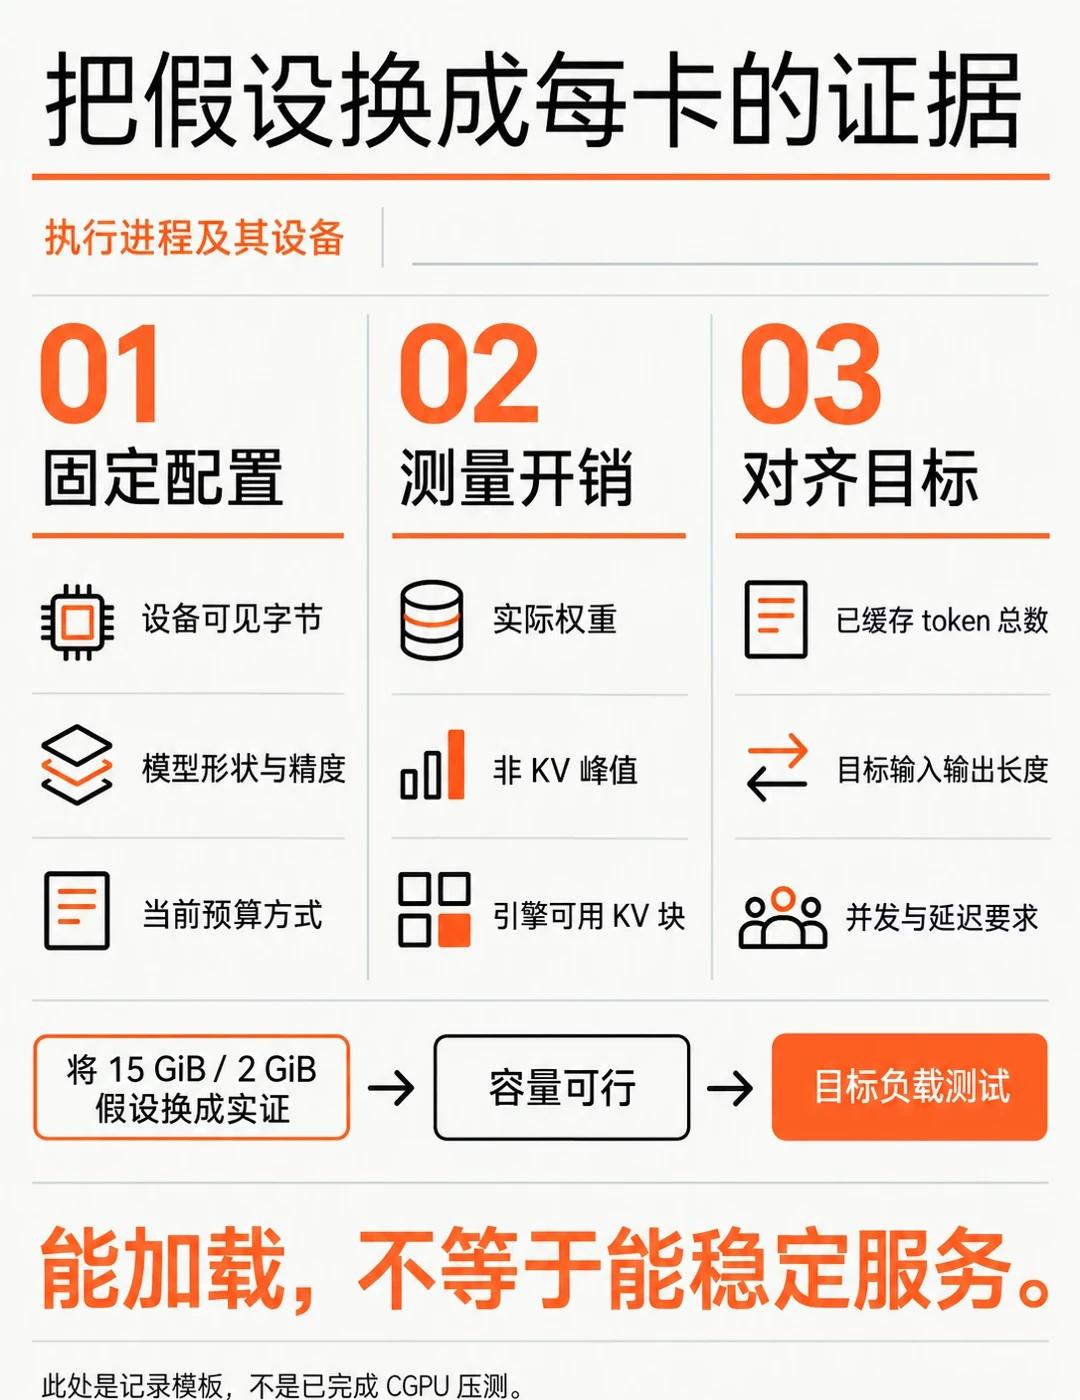
做一笔教学账:假设运行时看见24GiB,显式取预算比例0.9,权重记15GiB,其他非KV峰值预留2GiB。它们不是这款模型的实测占用。
剩余KV预算=24×0.9−15−2=4.6GiB。GiB是2的30次方字节,不能把厂商标称GB直接混进来。0.9也不是这里核验的vLLM默认值。
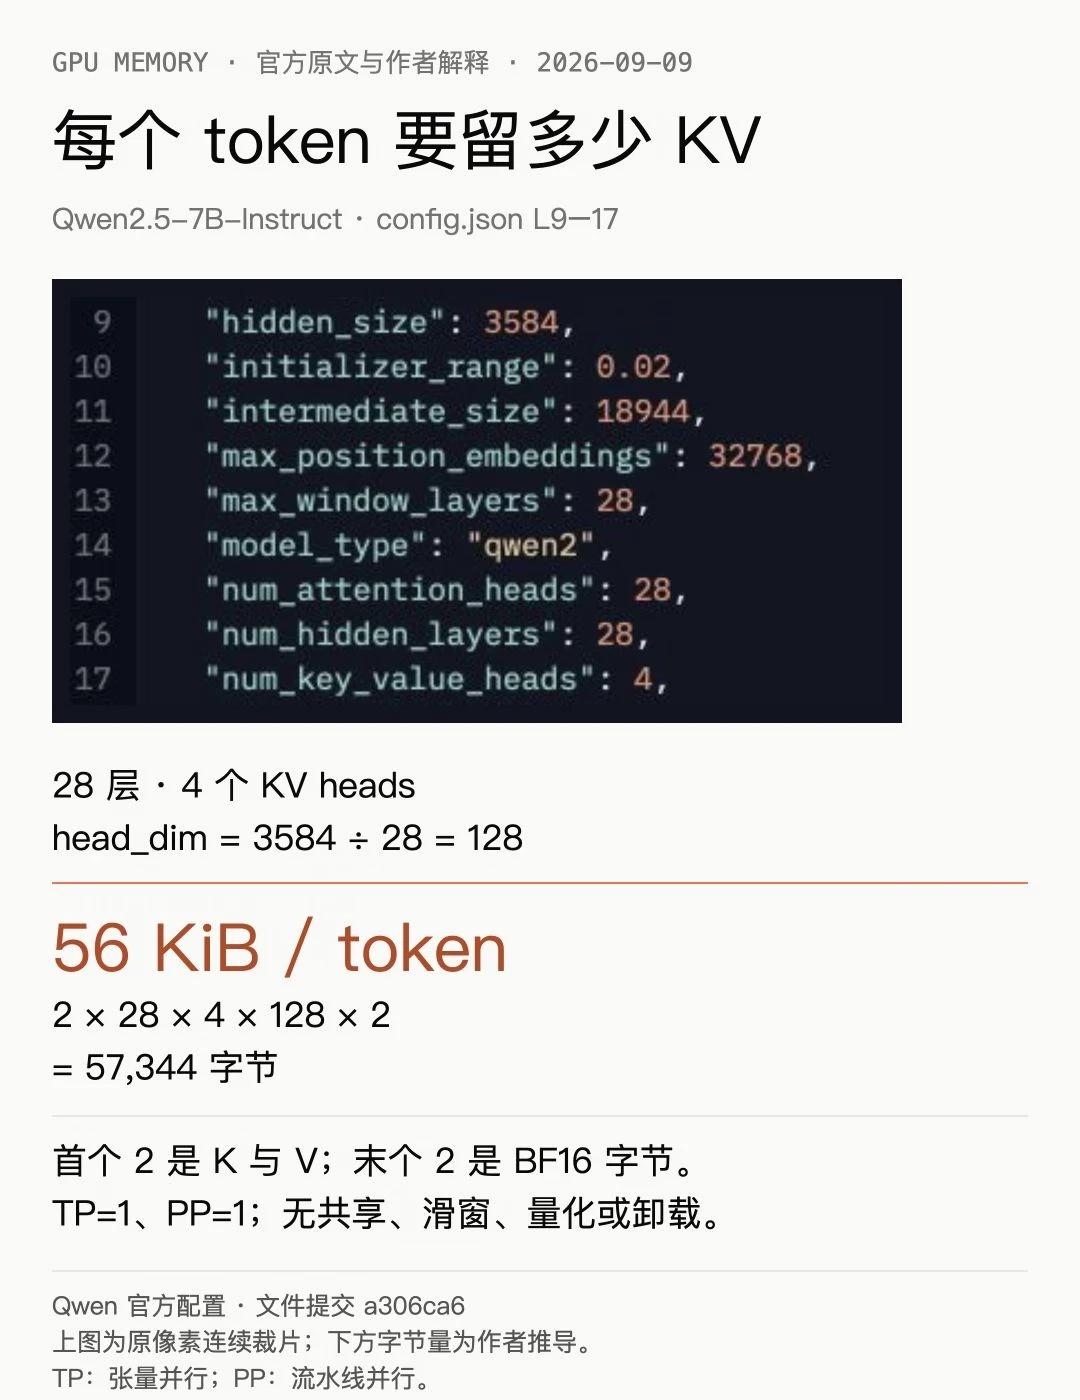
📐 再看Qwen2.5-7B-Instruct官方配置:28层、4个KV heads、28个Query heads、隐藏维3584,因此head维度是128。GQA算KV用4,不用28。
取BF16 KV,每元素2字节,张量并行TP=1、流水线并行PP=1,不启用共享、滑窗、卸载或KV量化。一个token在各层的缓存载荷是2×28×4×128×2=57,344字节,即56KiB。开头的2对应Key和Value。
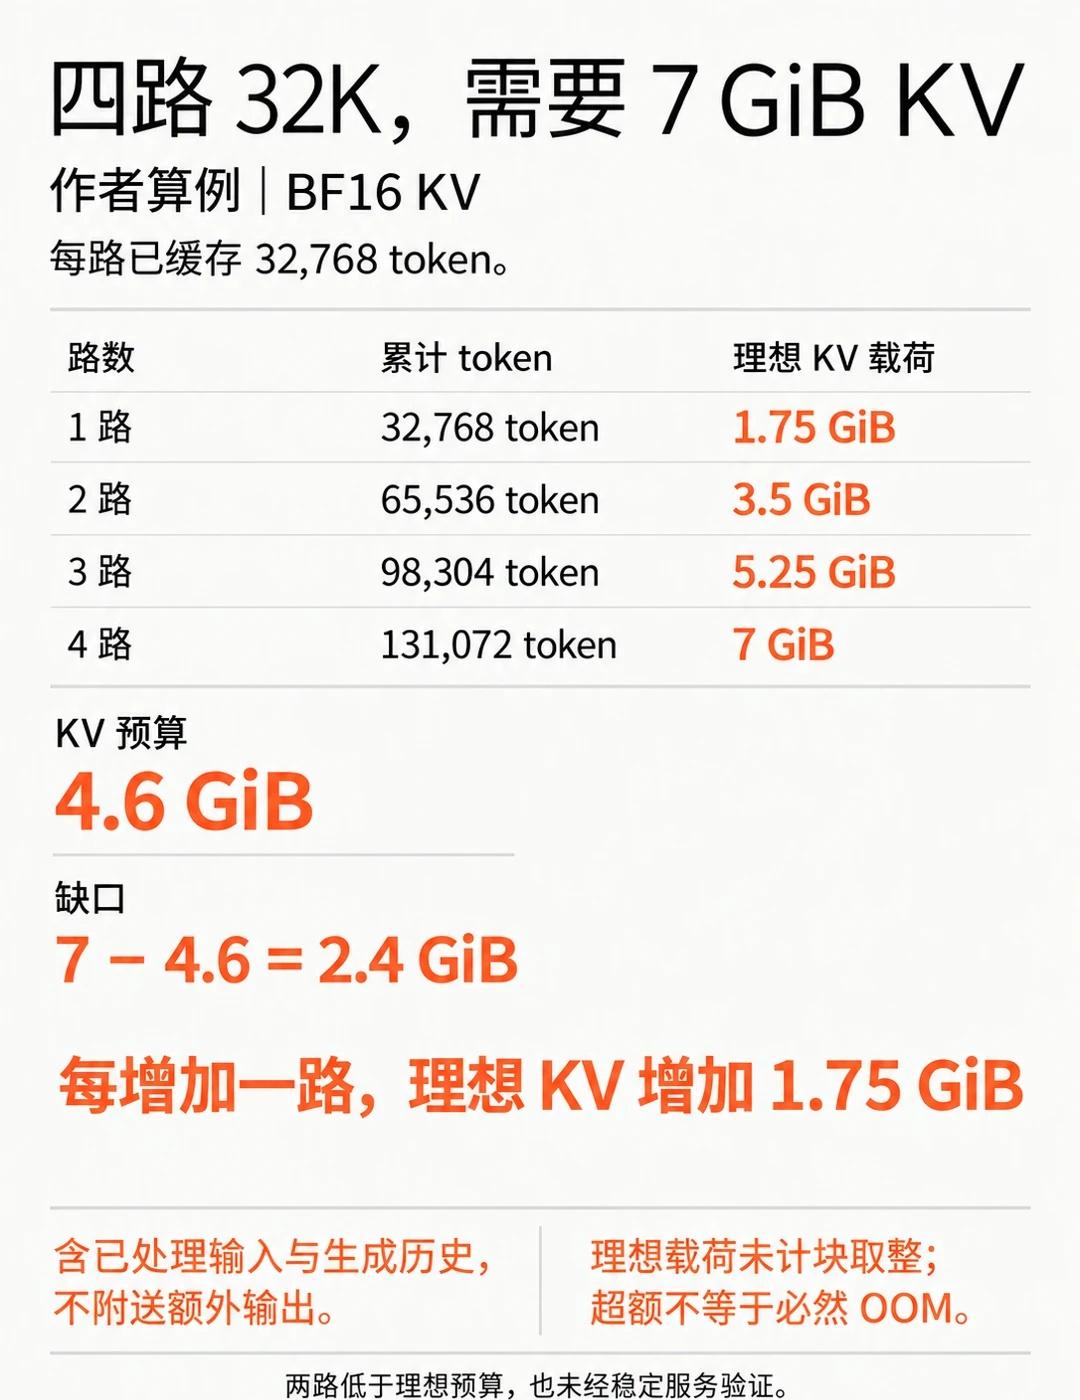
四路各缓存32,768个token,总量131,072,需要7GiB。这里包括输入与已生成历史,不是32K输入之外还免费附送输出空间。7超过4.6,所以这组假设不能支持目标同时驻留。
⚠️ 这不等于某张卡必然OOM。引擎可能让请求等待或抢占;实际块取整、临时峰值还要核实。两路理想值3.5GiB小于预算,也不能直接叫“稳定通过”。
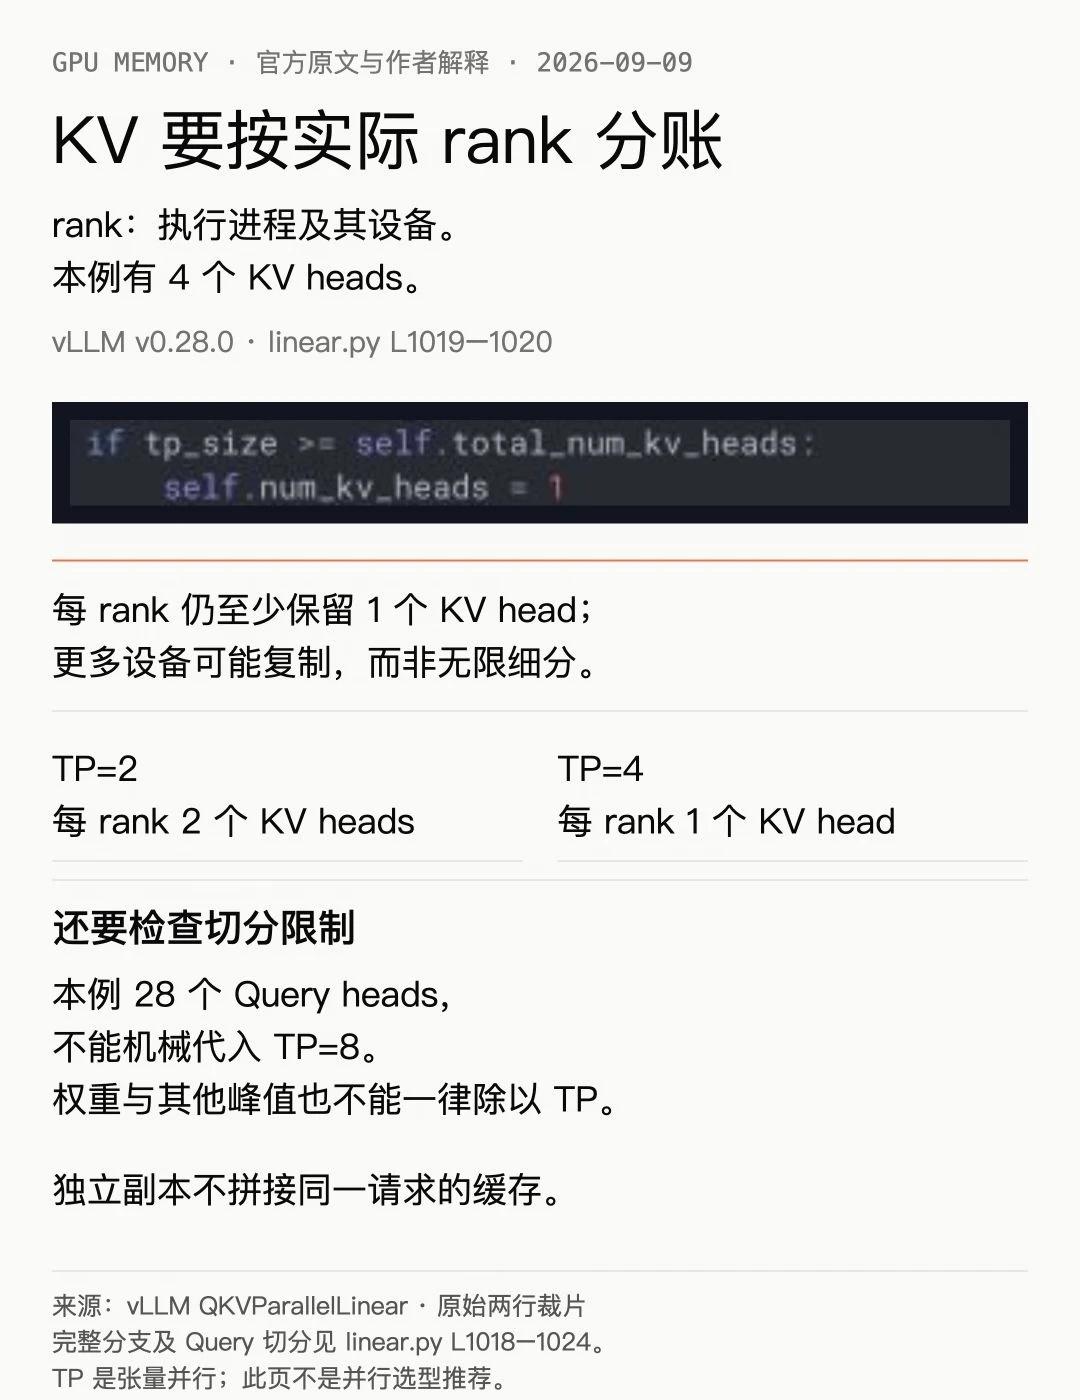
加卡时也别直接相加总显存。新建独立副本会重新占权重;TP则要看每rank(执行进程及其设备)实际持有的KV heads。vLLM的对应分支在TP达到KV head数后,每rank仍至少一个KV head,可能出现复制。不能无限除以卡数,更不能忽略Query head整除限制。
📝 最后留一份逐rank记录:设备字节、精度、预算方式、实测权重、非KV峰值、可用KV块、目标缓存token总和。把假设替换为证据,再测试目标负载的延迟与错误。减少长度或并发会缩小承诺;改变权重精度不会自动改变BF16 KV。
依据Qwen配置与vLLM v0.28.0,2026-09-09核验。仅算术复核,无模型加载、GPU压测或性能结论。
大模型部署 GPU 显存 KVCache vLLM 进化生活howto AI新手村 AI搞事业howto AI反常识howto AI