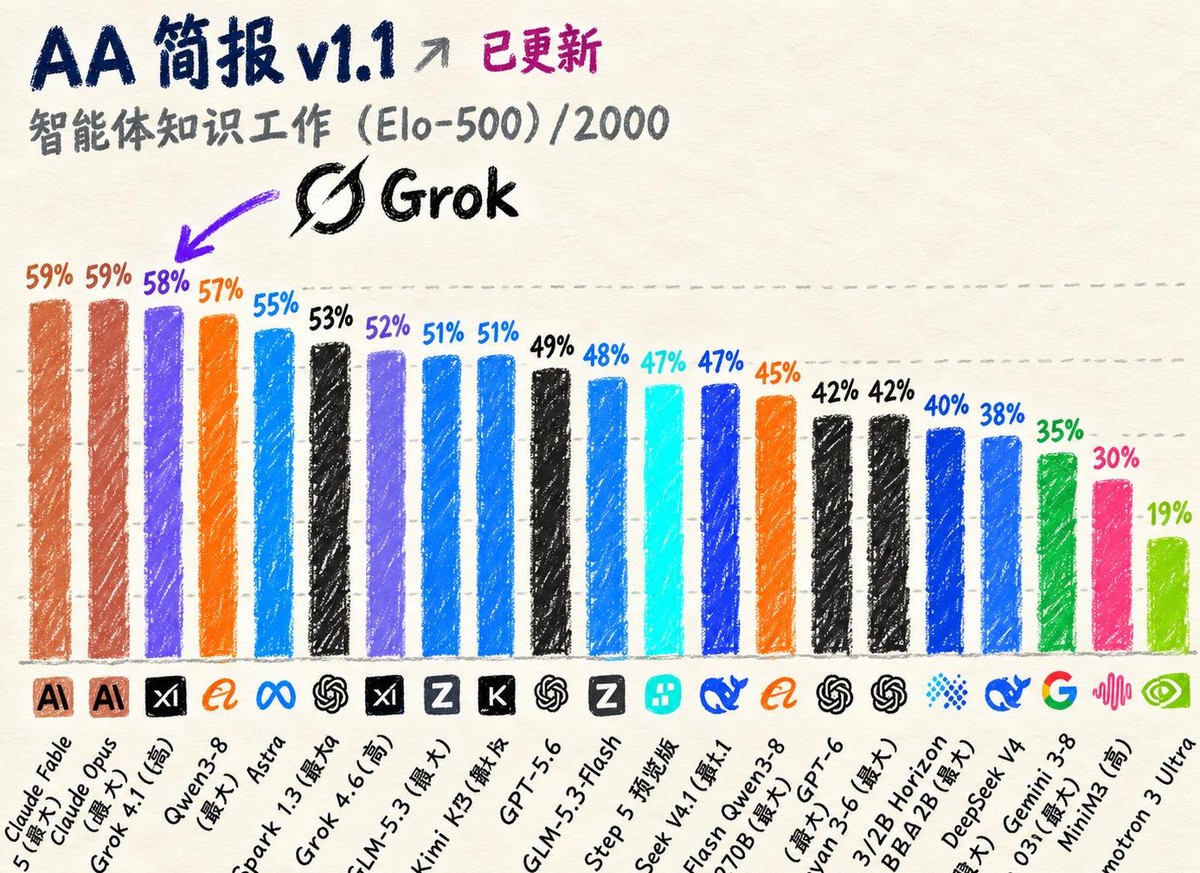
Grok 4.7 xHigh 在 AA-Briefcase v1.1 上拿下 1657 Elo,比上一代暴涨 111 分,离榜首的 Claude Opus 5.5 只差一步。当年那个被嘲“社交平台黄毛”的选手,现在干起脏活来比谁都硬核。Qwen3.8 Max 以 40 分的 Intelligence Index 紧随第一梯队,百万 token 上下文塞进去照样稳。Kimi K3 更狠,1543 Elo 仅次于 Claude Fable 5,但跑一个任务要将近一个小时,贵的让人肉疼。GLM-5.3 在 GDPval-AA 上从 1524 飙到 1770,涨了 246 分,可惜最强的那个模型只敢对安全合作伙伴开放。DeepSeek V4.1 Flash 是另一条路,成本只有对手七分之一,Agent 能力追平 GPT-6 Astra,便宜得像在发福利。
但 AA-Briefcase 的残酷真相是:哪怕最强的 Claude Fable 5,91 项任务里也只有 3% 能完全过关。给 AI 一个塞满错误数据集的压缩包,让它自己写代码、调 API、洗表格、出报告——这条路还长着呢。