[CL]《Dream-RSI: Recursive Self-Improvement through Evolving Worlds》T Zheng, X Wu, Z Zhang, Z He… [Google] (2026)
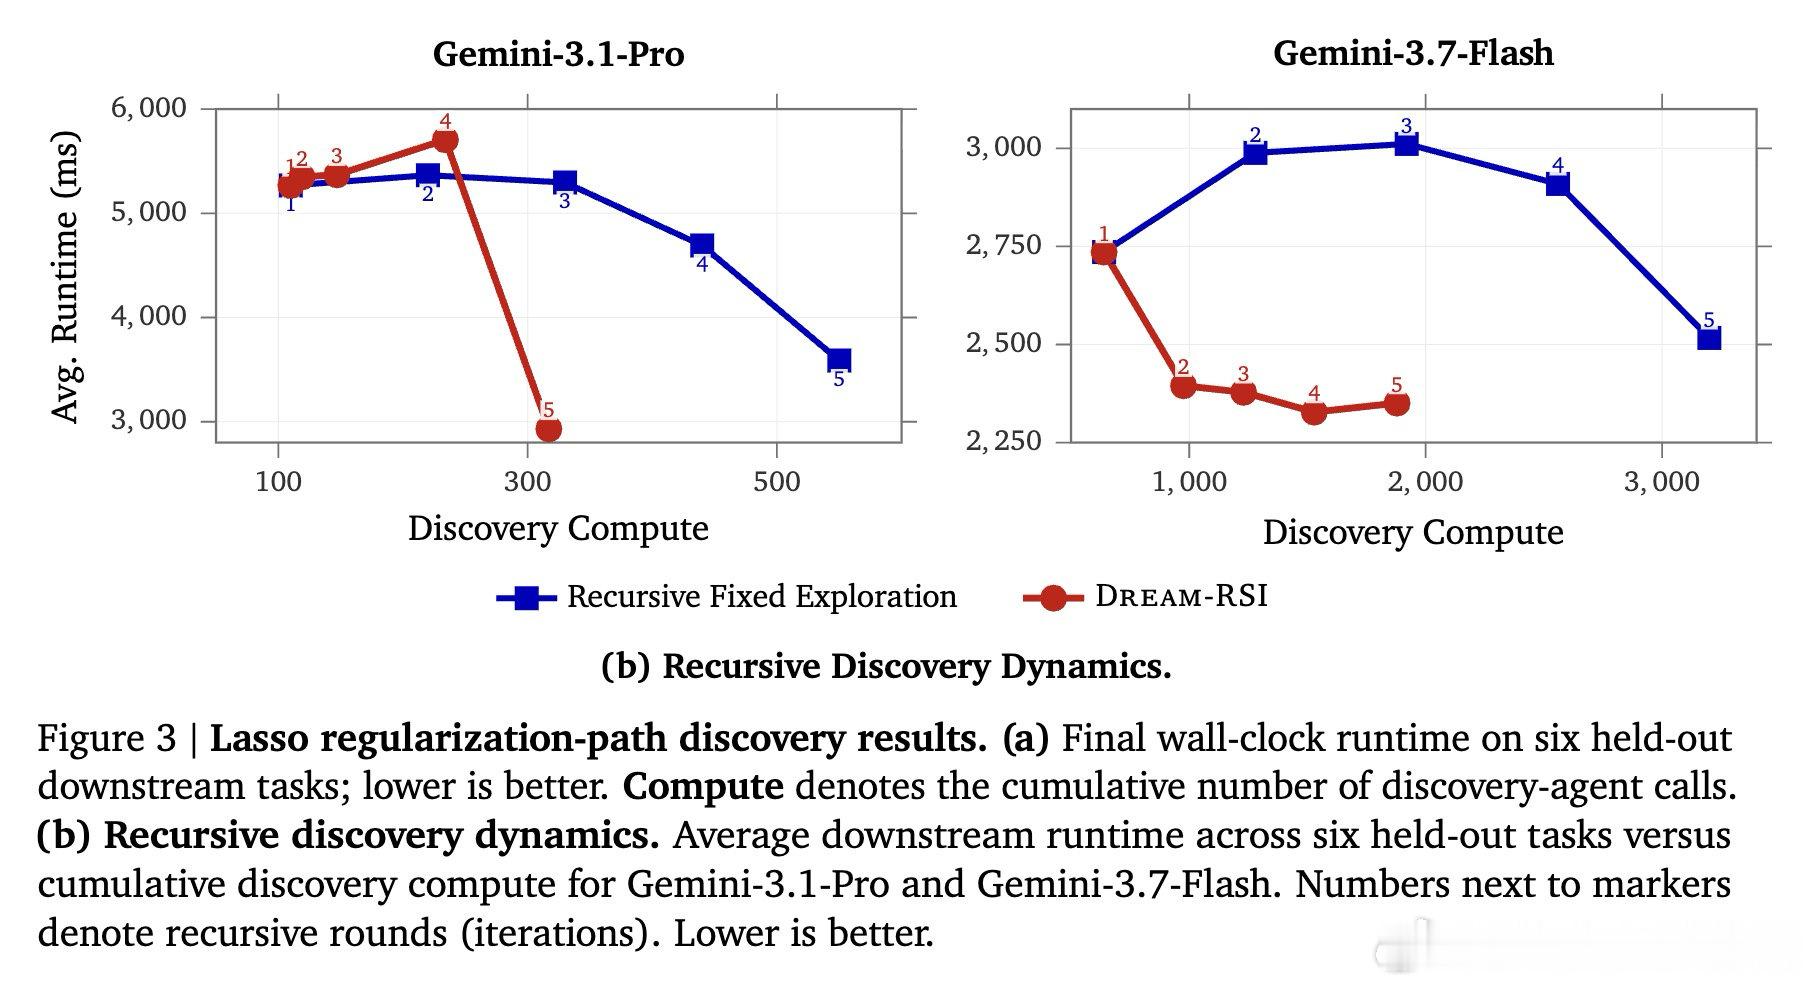
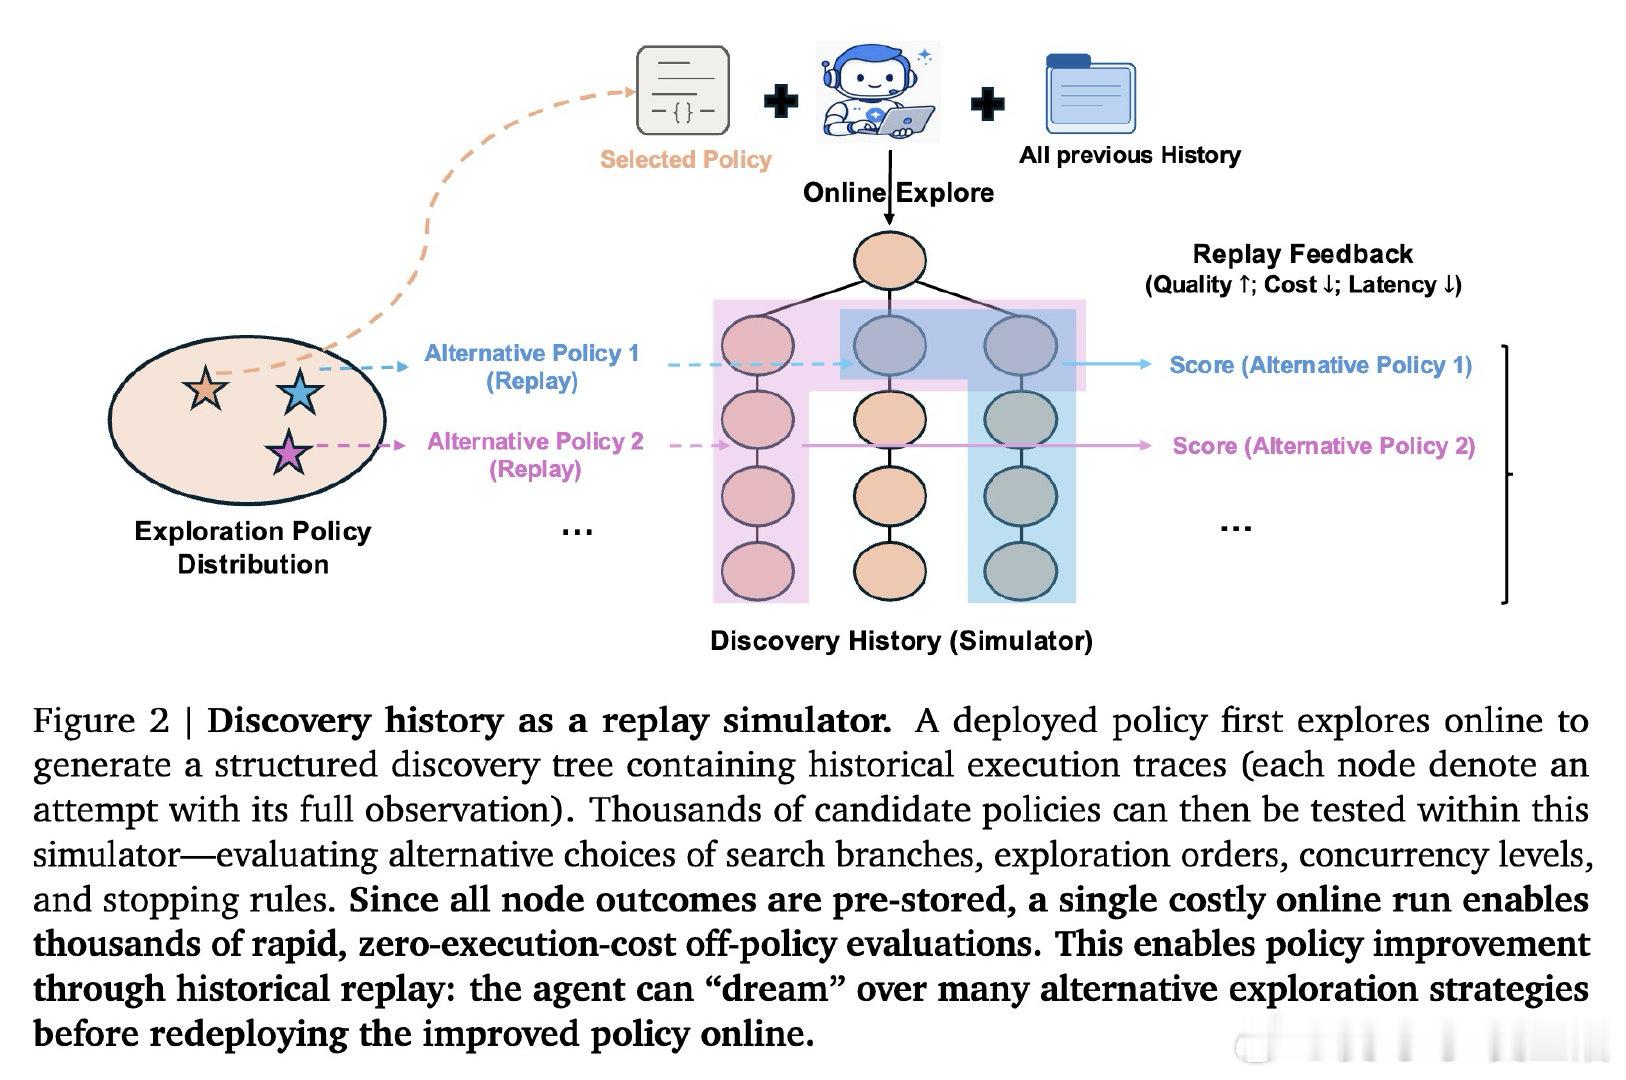
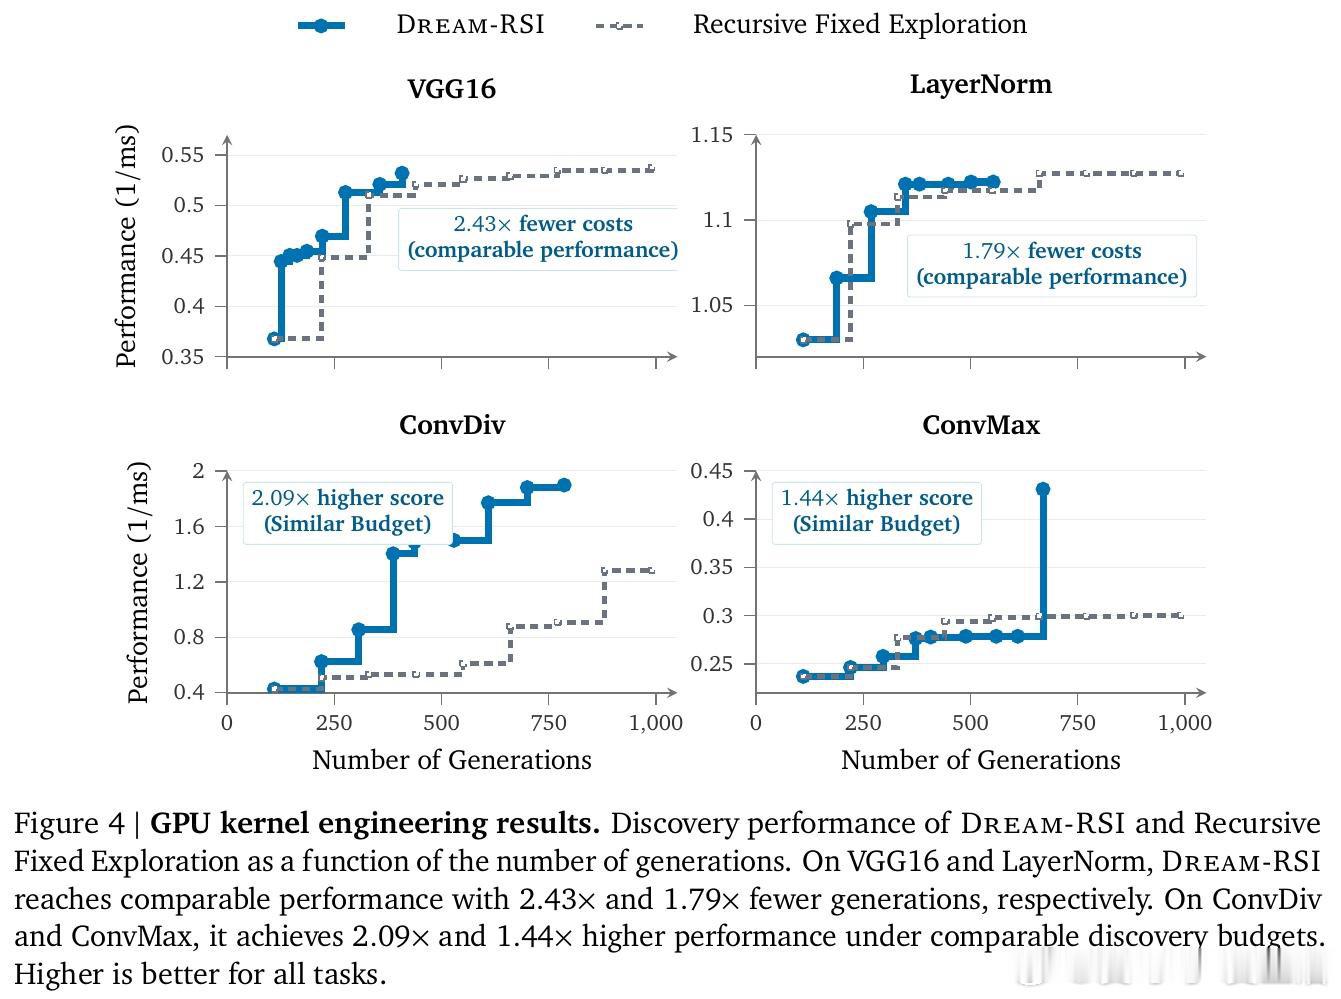
在AI智能体自提升领域,优化其探索策略是一个难题。过去的方法受困于固定策略或昂贵的在线调整,本质原因是评估新策略需要漫长且高代价的真实运行,反馈极慢。
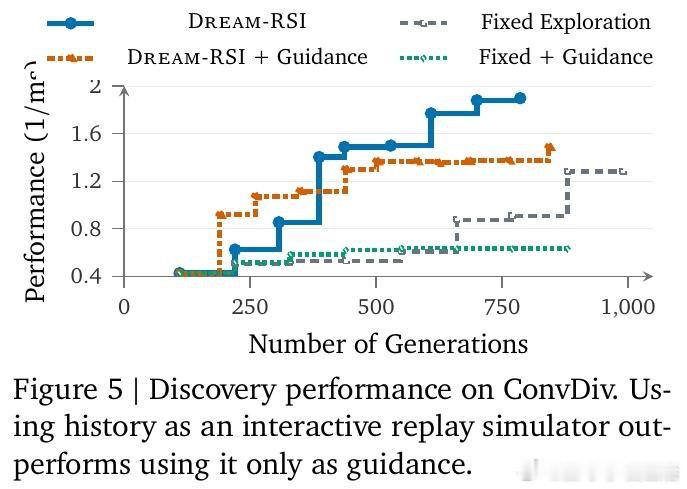
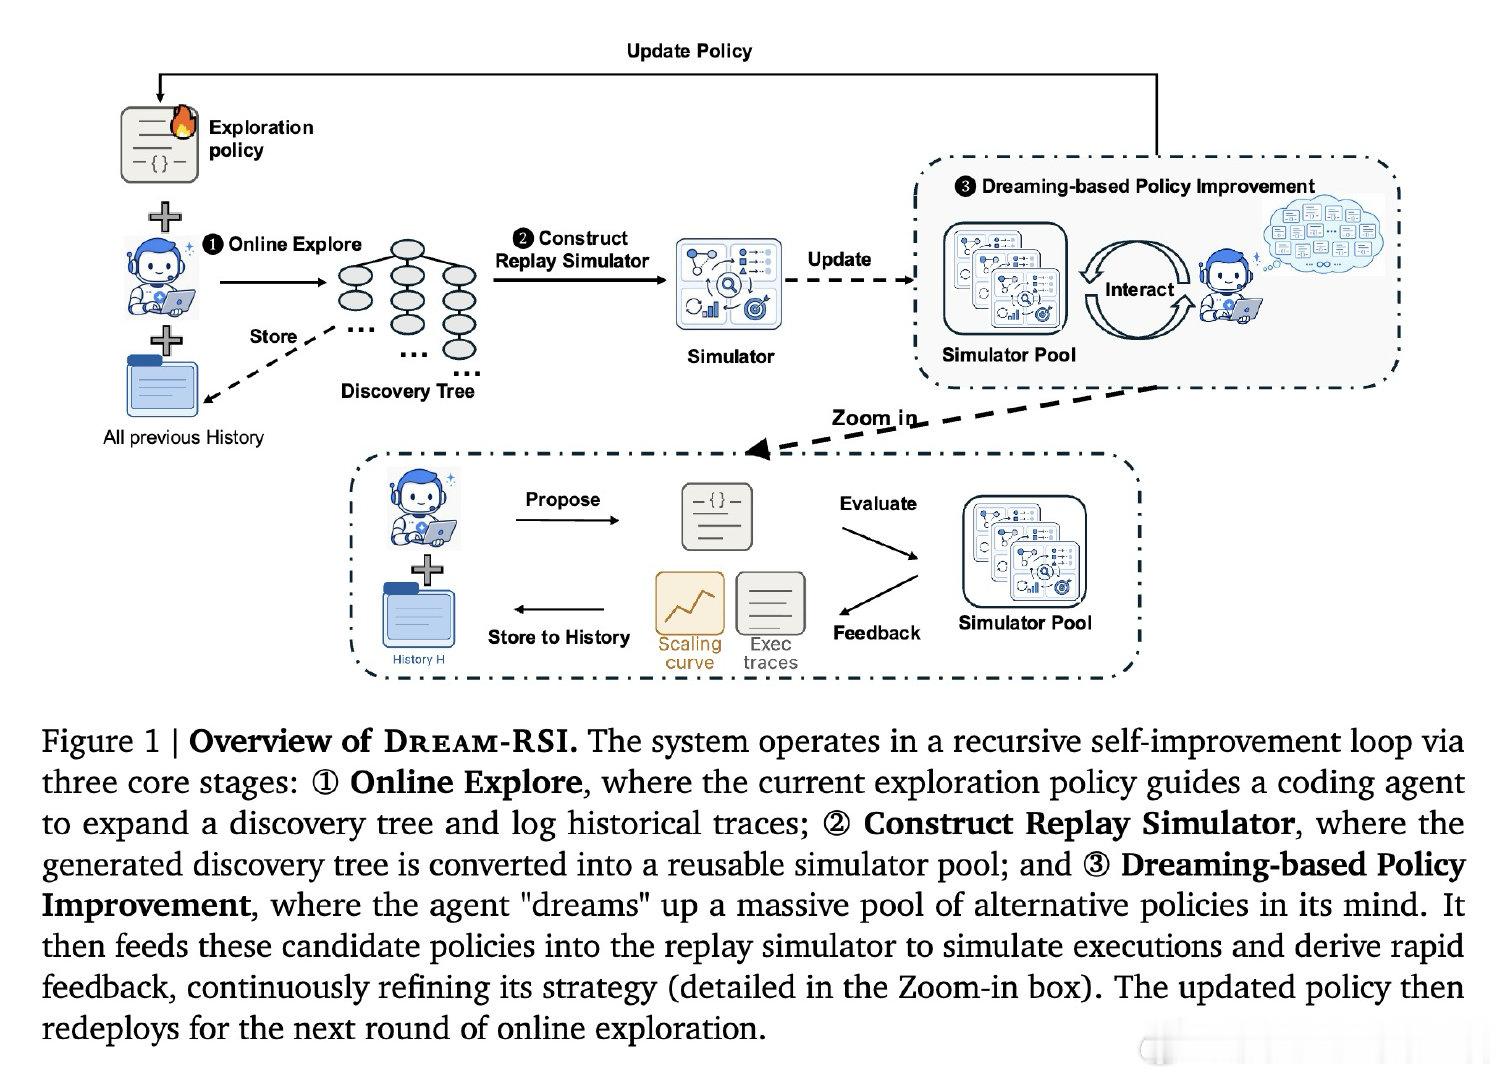
本文的核心洞见是:把已完成的探索历史重新看作一个可重放的模拟器。由此,在模拟器中“做梦”这一关键操作,让系统能以零成本快速评估海量新策略,使问题得以解开。
这项工作真正留下的遗产是,一种将高成本在线元优化转化为低成本离线模拟的范式。它为智能体“学会探索”打开了新门,但尚未跨过的门槛是,策略对历史未覆盖的全新空间的泛化能力。
arxiv.org/abs/2609.14858 机器学习 人工智能 论文 AI创造营