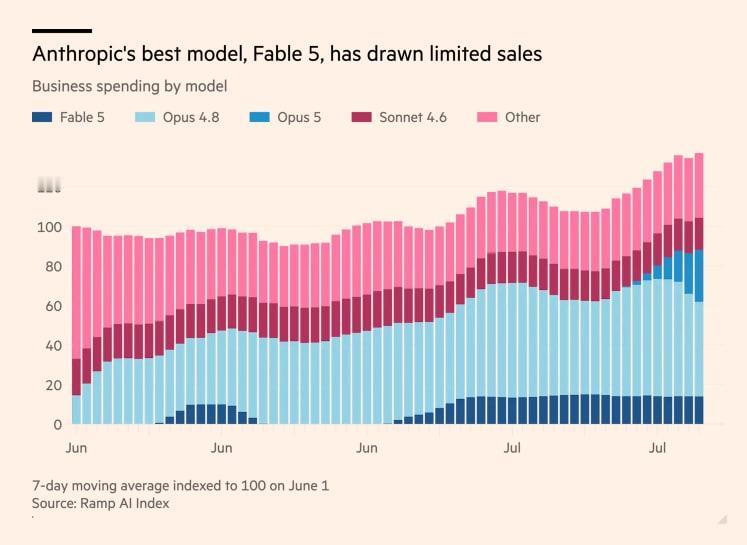
Claude 第一贵的旗舰,用起来的人不到十分之一。Anthropic 的 Fable 5 在自家付费 token 里只占 6%,定价却是 Opus 5 的两倍,也就是说,更高端的那一档被自家兄弟从使用面压到墙角。
真正扎人的是另一组对照:Opus 5 在 CursorBench 3.2 这种实际编程任务里,只落后 Fable 5 大约 0.5%,而每任务成本是 Fable 5 的一半。多花一倍钱,多买到半个百分点的能力点。到底是不是用户真的不需要前沿能力,还是根本不愿意为这点边角溢价买单?
答案大概藏在 6 月那次强制下架里。客户在那次被动中断中被推着去找备份,验证完、跑通流程、甚至改好了 prompt,等 Fable 5 重新上线,原来的预算和习惯已经长进流水线里。多模型采购习惯一旦固化,想拽回来就难。
对企业采购来说,这反而是更实在的工作方式:按任务难度分模型,能让 Opus 5 干的,就别堆到 Fable 5 上。即便贵一倍的旗舰性能再强,企业账上算的是单位任务的边际收益。Anthropic 自己也在调整后跑出了运营利润,正好印证:客户向下迁移,平台未必亏,只要算力成本降得更快、毛利结构撑得住。Anthropic 真正要担心的,是下一代旗舰还没上量,就已经被上上代的 Opus 先把自己咬一口。选型这件事,将来会越来越像配比,不再是“全量上最强”。
你团队现在分任务的边界,是按能力卡死,还是按价差优先?