斯坦福刚庆祝完"CT界ChatGPT",半年不到,中国团队直接把纪录翻篇了。
做医疗AI的公司,过去十年走的几乎都是同一条路:挑一种病,花两三年训练一个模型,做出来也只能看这一种。肺结节一个模型,肝囊肿又一个,胰腺癌再来一个。行业里管这叫"一病一模",听起来专业,说白了就是偏科。
这条路走了十年,没人觉得有问题。直到斯坦福今年3月在《自然》发了一篇论文——一个叫Merlin的模型,能同时识别腹部CT上30种疾病,美国媒体激动地管它叫"CT界的ChatGPT"。但有个硬伤:准确率还没到医生平均水平。
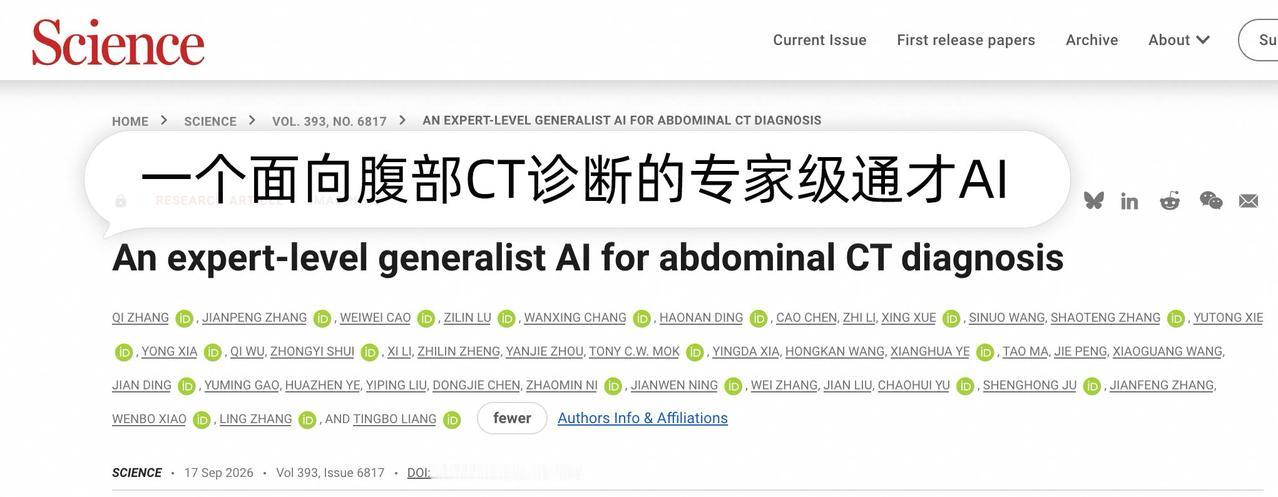
然后9月18号,中国团队在《科学》上交了另一份答案。
达摩院联合浙大一院等机构做的DAMO RADAR,一个模型覆盖腹部18个器官、146种病症,首次达到影像科专家水平。146对30,这个数字差距已经说明问题了。更关键的是水平——近4万次真实世界检查中AUC达到0.913,14家机构26名医生参与人机对比,仅3名资深医生略优于AI。有AI辅助后,医生准确率提高10%,用时减少30%以上。
它怎么做到的?核心是一个叫"器官级细粒度对齐"的技术——不是整个腹部混在一起看,而是按肝、胆、胰、胃肠等器官分别理解。模拟医生的读CT逻辑,从"只会做一道题"变成了"一整门课都学完了"。
过去行业觉得医疗AI进不了临床主战场,就是因为偏科。DAMO RADAR把这条路蹚通了。而且连模型带代码全开源了,成果是自己的,路留给全世界走。