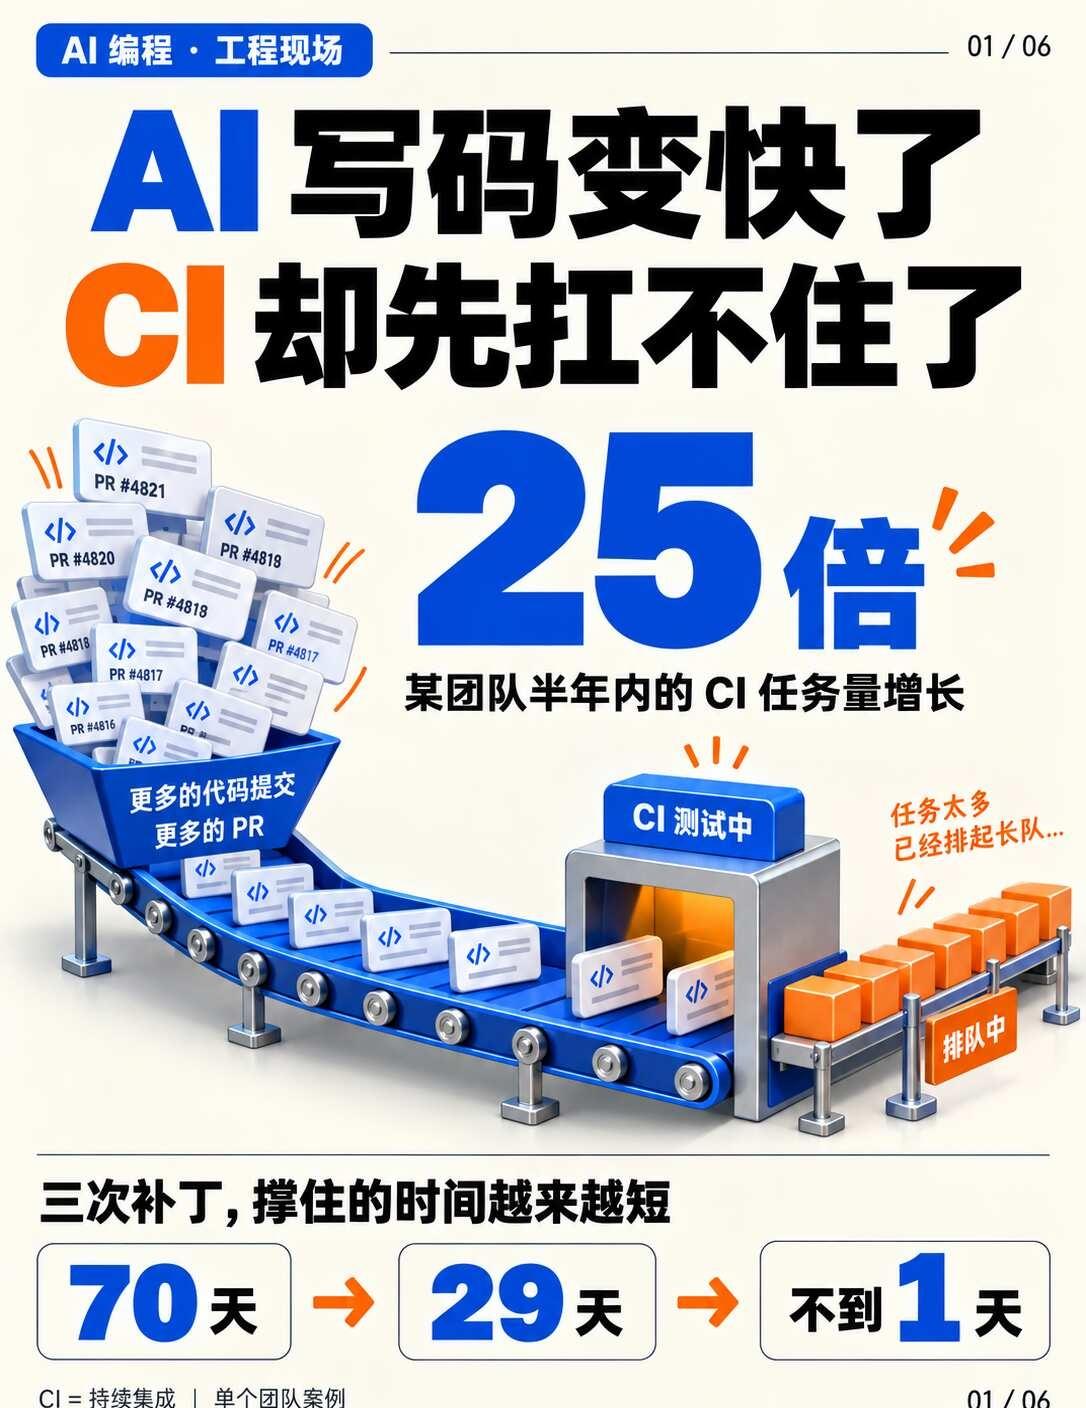
AI写码变快,CI却先扛不住了
AI 写代码越来越快,工程团队就一定交付得更快吗?
一篇技术复盘显示:写码提速后,CI(持续集成)可能先排起长队。
📈 某研发团队给出了一组数字:
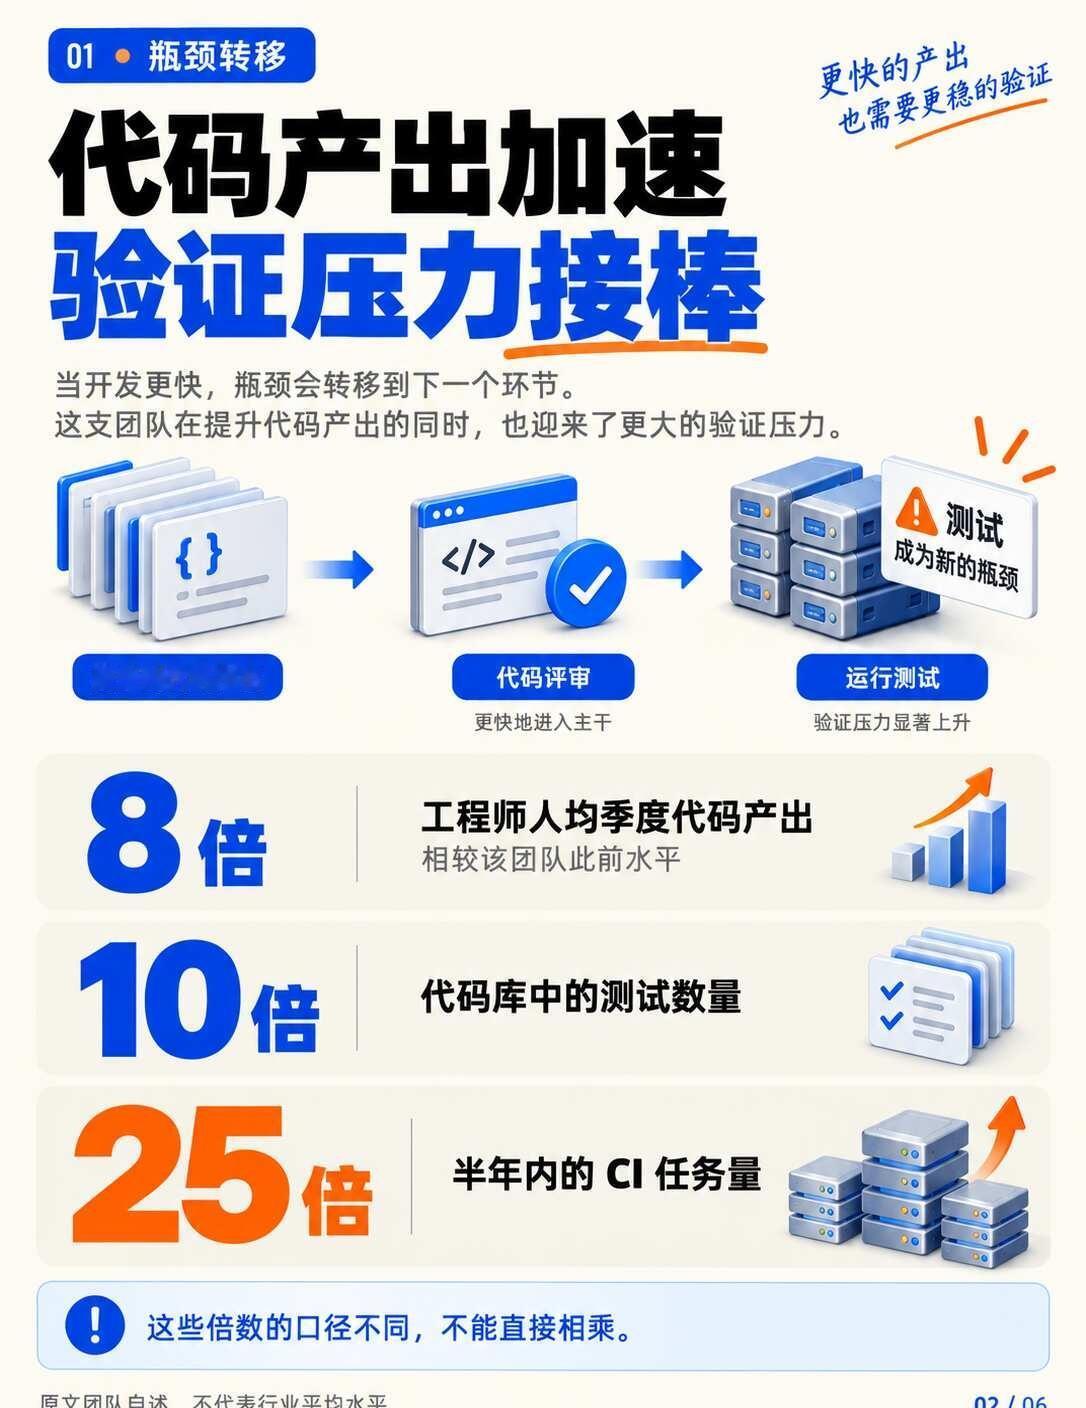
人均季度代码产出达到此前的 8 倍,测试数量增长到 10 倍,半年内 CI 任务量增长到 25 倍。
① 为什么不每次都跑全部测试?
PR(代码变更请求)和测试都在增加,全跑越来越贵。他们用“测试影响分析”,结合历史结果和代码包相关性,选择本次要跑的测试。
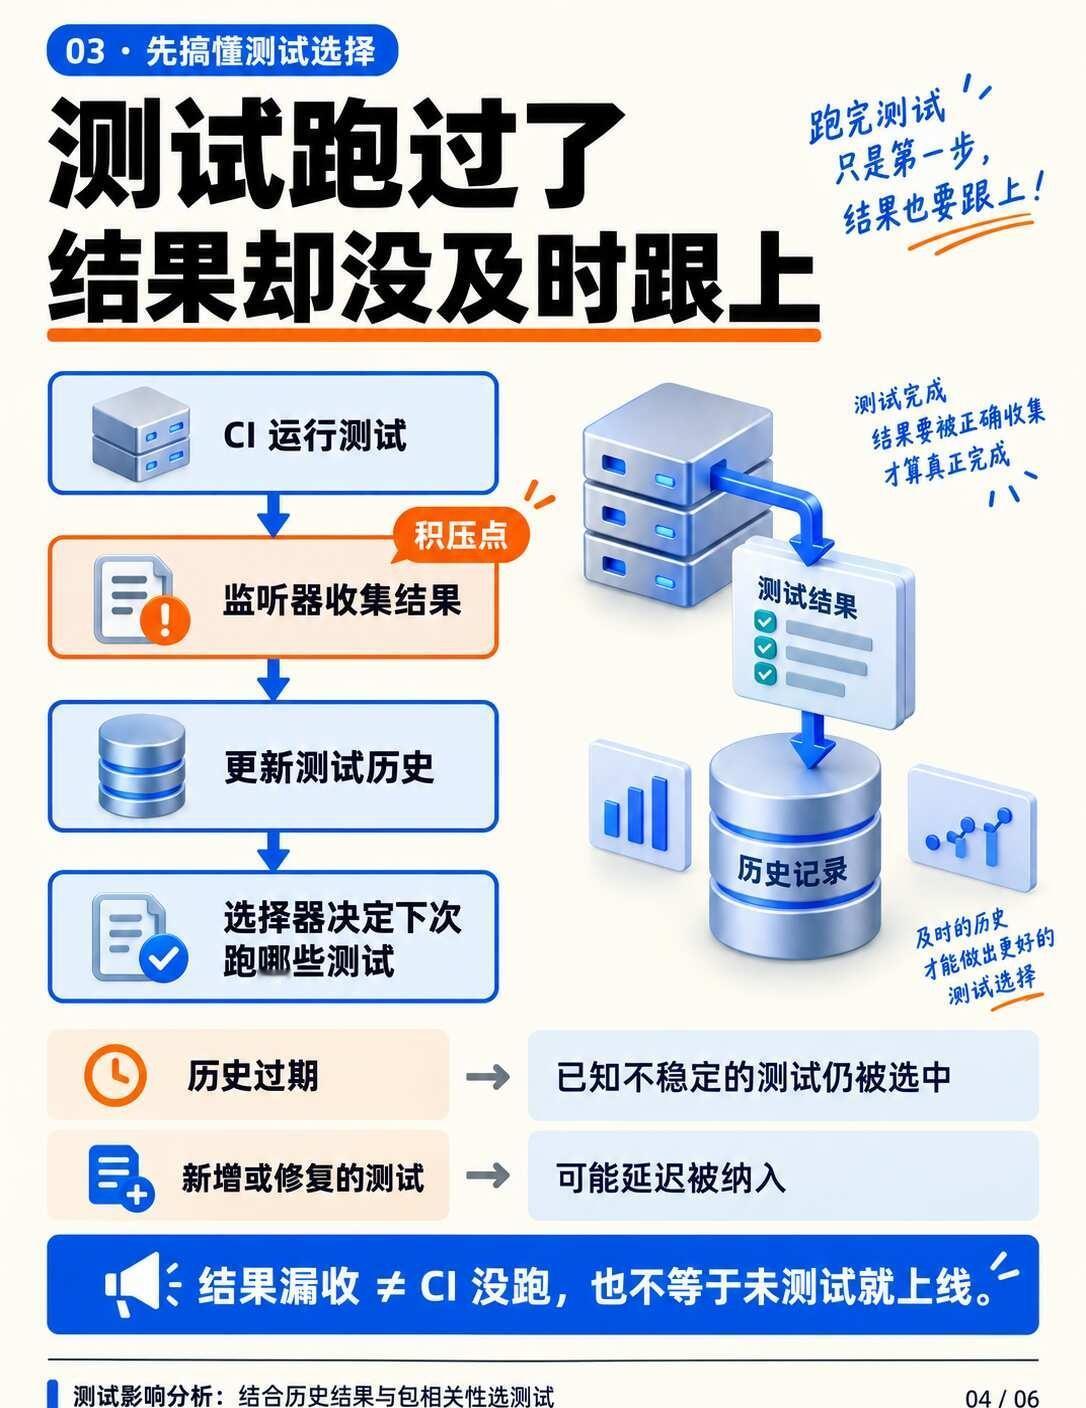
这套服务有两个角色:监听器收集 CI 结果;选择器读取历史,决定下一次跑什么。问题在于,监听器渐渐追不上新增任务。
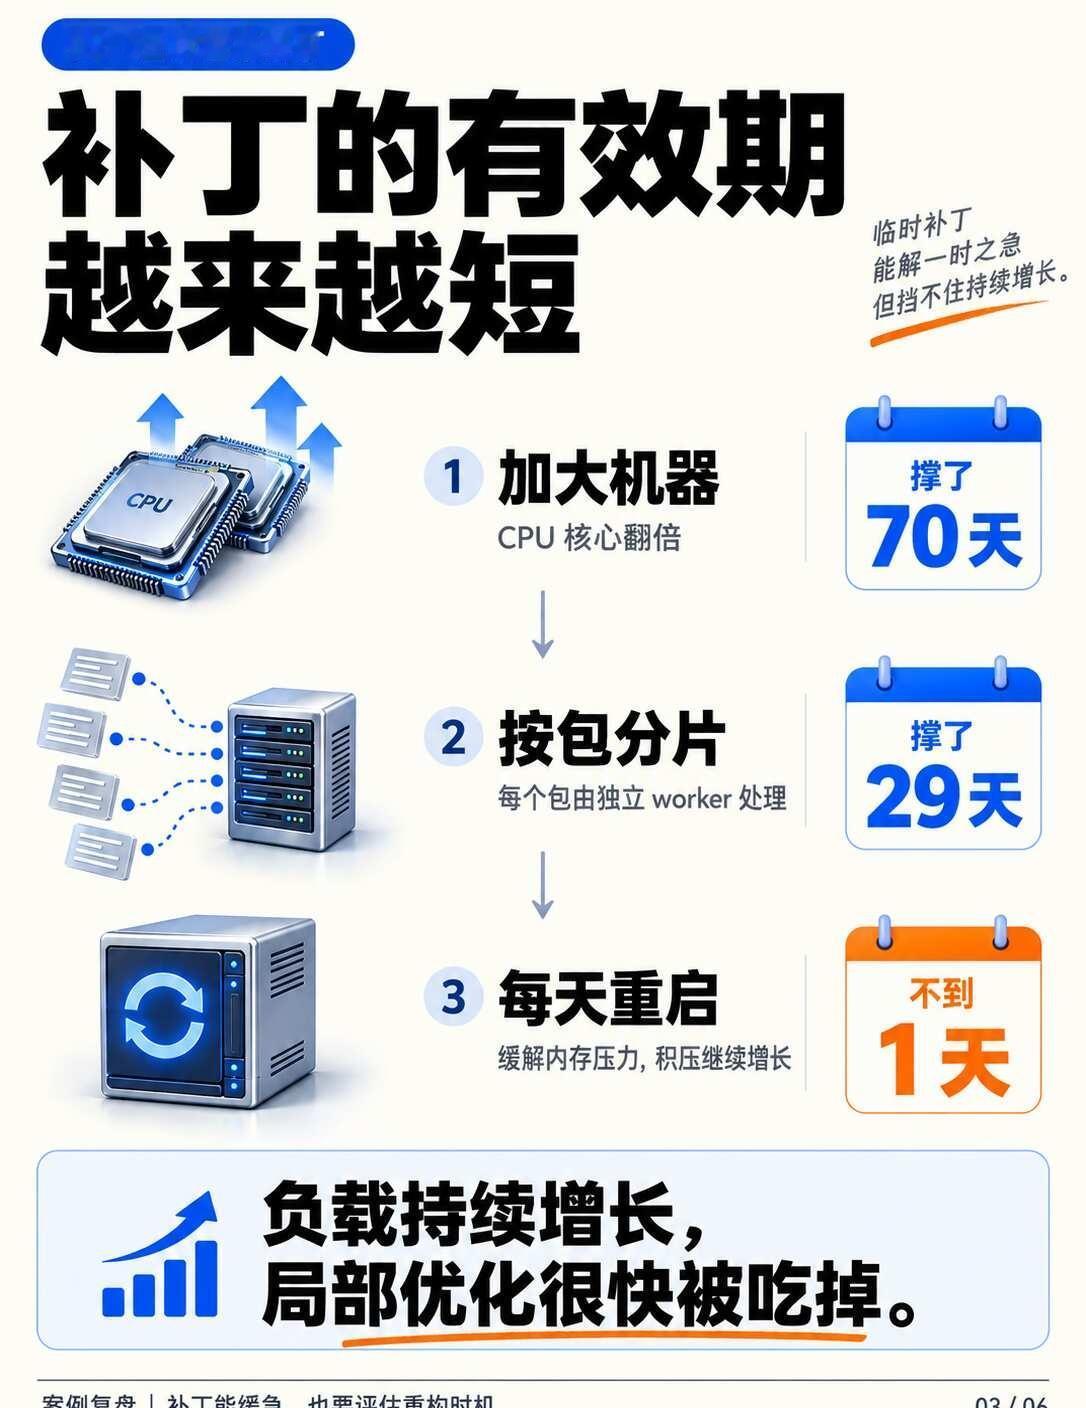
② 三次补丁,保质期越来越短
第一次:CPU 核心翻倍,撑了 70 天。
第二次:按代码包分片、并行处理,撑了 29 天。
第三次:每天重启缓解内存压力,不到一天又顶不住。
负载增长,很快吃掉优化余量。
③ 结果积压,意味着什么?
测试可能已经跑完,但结果没被及时收集。选择器拿着旧数据,仍然选中已知不稳定或普遍失败的测试;新增、修复的测试,也可能延迟被纳入。
这里必须分清:结果漏收,不等于 CI 没跑,更不能直接写成“未测试就上线”。
④ 最终,他们改了什么?
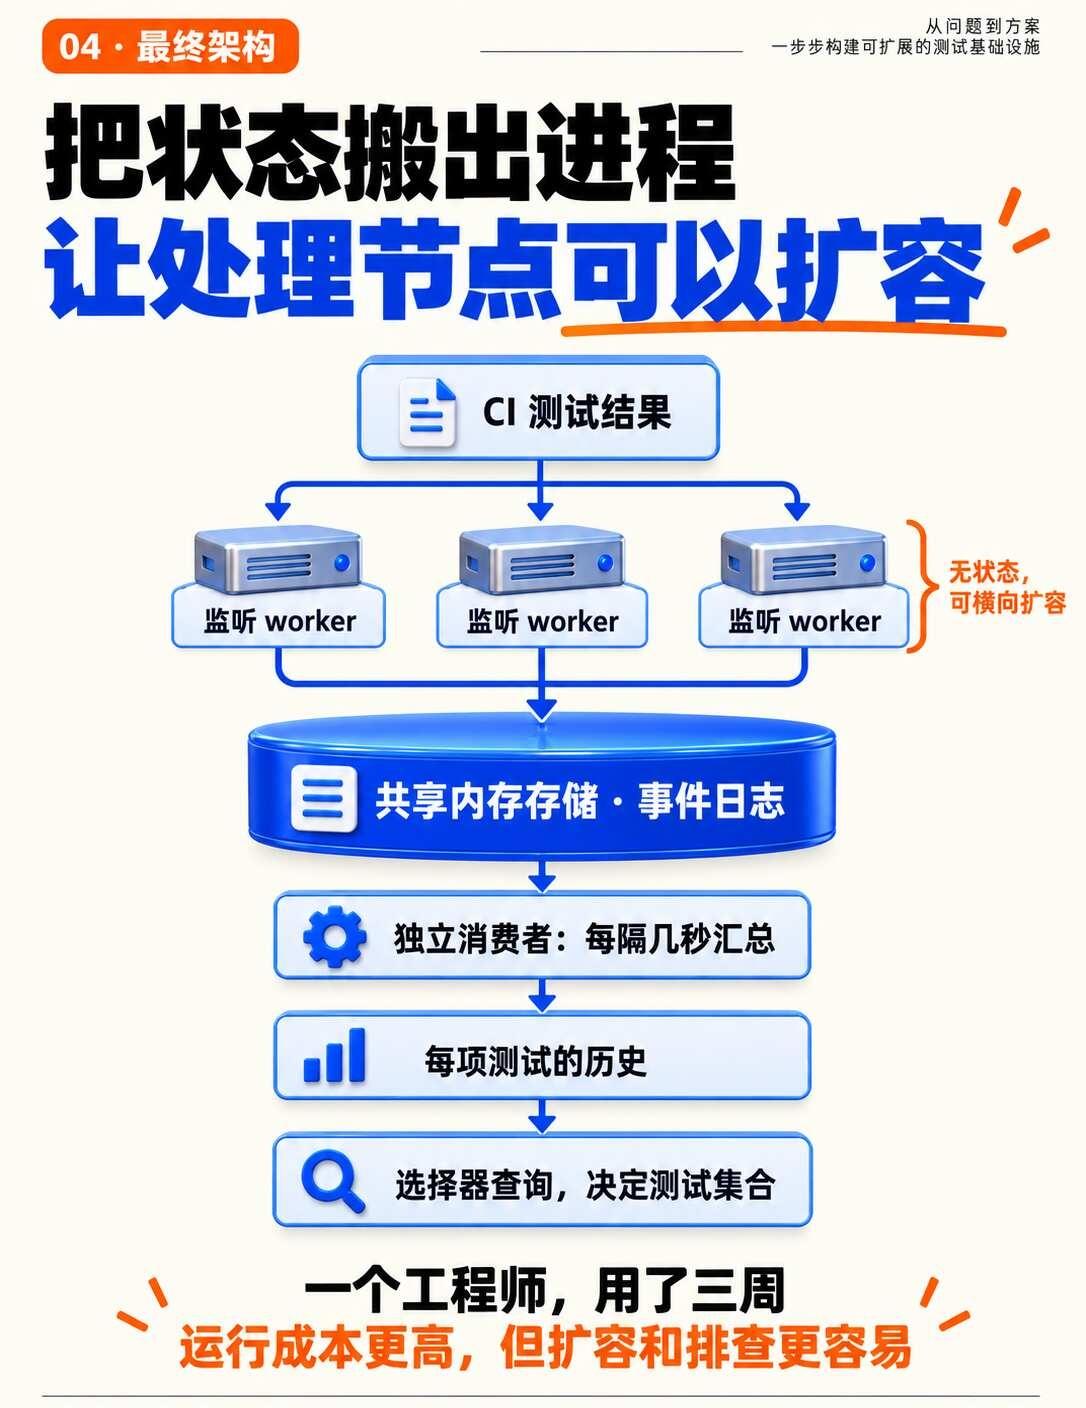
把状态从工作进程里搬走。
多个无状态监听 worker,把结果追加到共享内存存储中的事件日志;独立消费者每隔几秒汇总为各项测试的历史,供选择器查询。
增加监听 worker 即可扩容,单个进程不再扛全部状态。
代价是运行成本更高。回报是更容易扩容和排查内存问题。按原文自述,重构由一名工程师用三周完成,调优后保持稳定。
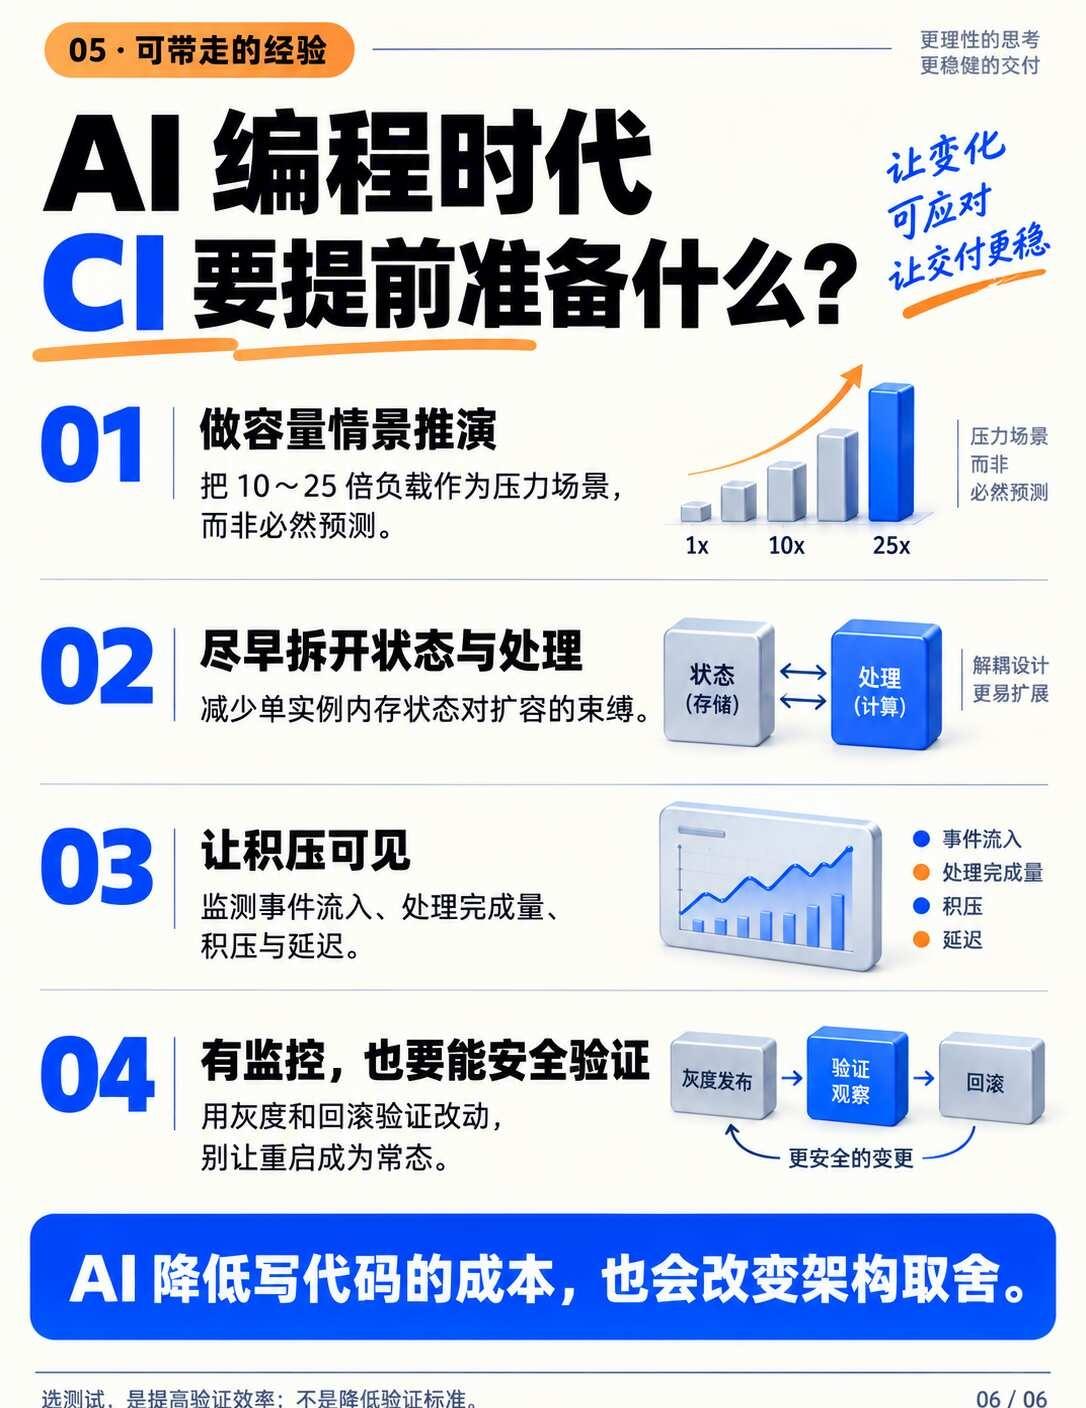
10~25 倍是压力情景,建设规模仍看业务和预算。
AI 也可能缩短重构时间。“继续补丁”与“现在重构”的取舍,值得重算。
agent