Agent能力大幅升级!豆包大模型2.1 Pro 0915新版正式上线,代码与多模态迎来跨越式进化
9月16日最新消息,火山引擎正式对外官宣豆包大模型2.1 Pro迎来0915版本重大更新,新版本API已经在火山方舟全量上线。用户更新豆包App之后,直接选择“豆包2.1 Pro(0915新版)”模型就能够体验全部新能力,同时TRAE、Doubao‑Seed‑Evolving产品也同步完成版本升级,企业接入无需更换API节点,升级成本很低。这次更新瞄准企业生产场景发力,不再只是简单的对话能力微调,而是在Agent自主任务、多模态编程、视频图像理解以及运行成本四个维度同步迭代,标志着国产大模型正式向着稳定落地的工业级应用继续迈进。
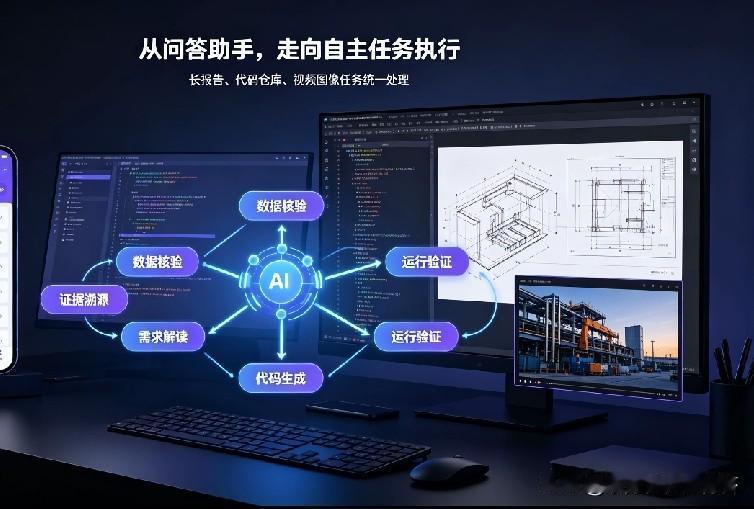
很多人在使用AI做复杂任务的时候都会遇到同一个痛点:大模型容易“一本正经地编造内容”,也就是大家常说的幻觉。一旦用来撰写行业报告、整理专业资料,虚假信息会带来很大麻烦,这也是阻碍Agent落地的最大障碍。本次新版最核心的突破,就是针对Agent任务交付能力进行深度补强。模型新增了更加完善的证据溯源、权威信源检索、时间时效判断以及多源数据核验机制,大幅度减少幻觉问题,调用各类工具执行任务的时候更加严谨可靠。
在金融投研、自动化办公这类需要产出长文档的业务场景,提升效果尤为突出。以金融投研举例,新版模型自带分析师级分析框架,可以自主拆解一份复杂的研究需求,自动检索高质量数据源,自主建模运算,直接产出一份具备专业结构的底稿。这代表AI不再只是被动回答问题,而是能够自主规划、分步执行、交叉验证,朝着真正可以自主干活的智能体迈出坚实一步。
除了Agent之外,多模态Coding是本次更新另一大亮点。软件开发领域一直期待AI能够读懂完整项目仓库,而不是只处理一段孤立代码片段。新版模型对大型代码库的理解能力得到强化,面对跨文件、长链路的复杂工程,能够理清各个模块之间的依赖关系,定位故障根源并且完成修复,覆盖需求解读、编码、运行验证的完整开发链路。依托VLM视觉能力,它还能直接看懂设计稿、工程图纸、屏幕录屏画面,把视觉素材转化成前端代码甚至游戏逻辑,对于Web3D、独立游戏开发者来说实用性很强。
多模态理解板块同样迎来全方位升级。视频推理能力大幅增强,支持在一段长视频里面定位关键证据,跨多帧整合信息给出答案,还可以对照SOP流程识别操作步骤并解释背后原理。物理教学、工程实操、医疗教学等专业领域内容理解更加精准,视频标注、内容质检、长视频摘要提取等批量工作都可以交给AI处理。图像解析层面,强化了三维物体、密集图文识别能力,可以识别CAD工件、游戏3D元素、AR空间布局,读取图纸上的尺寸公差符号,提取PDF、财报表格以及跨页脚注引用数据,专业文档处理精度再上一个台阶。
值得一提的还有Token效率优化。新版本降低了推理轮次以及工具调用消耗,图像、视频推理场景的Token消耗量相比上一代减少30%以上。在看图质检、视频审核这类高频调用的业务场景,能够直接降低企业使用成本,让大模型规模化落地变得更加划算。超大1024k上下文窗口搭配256k最大输出,也足以应对超大工程文档、完整代码仓库一次性送入处理的需求。
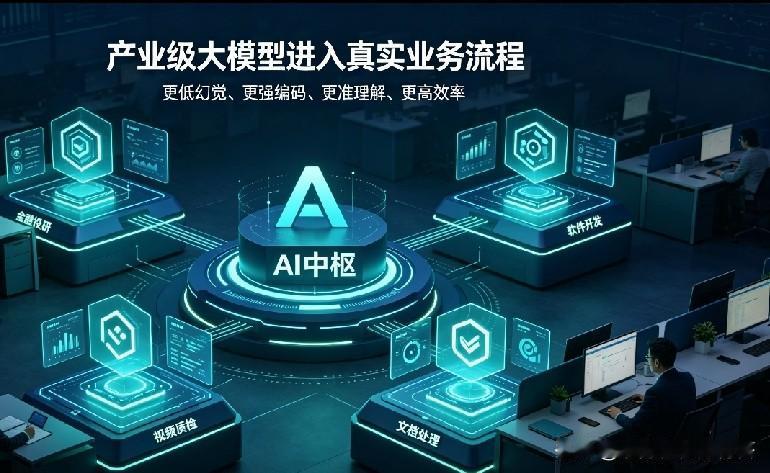
大模型行业已经告别单纯比拼跑分的阶段,能不能稳定落地到真实业务,才是下一阶段竞争的核心。豆包2.1 Pro本次0915版本升级,把重心放在降低幻觉、强化工程编码、优化多模态专业识别、压缩调用成本,全部都是产业端最迫切的需求。国产大模型正在一步步走出演示Demo阶段,走向真实的企业生产线。
大家觉得,AI Agent距离真正稳定落地办公、开发等工作场景,还需要解决哪些难题?欢迎在评论区聊聊你的看法。
前端开发模型 全栈国产系统 应用层开发 开源项目贡献 站群系统开发 内核之力 统一引擎供应商 开源AI生死局