AI 视频终于不用抽卡了
我靠,这个方法真有点东西。
以前做 AI 视频,基本都是:
写提示词 → 点击生成 → 镜头错了 → 人物动作错了 → 继续抽卡。
但只要画面里出现复杂运镜、人物走位、转身、上下楼梯或者多人互动,单靠文字很难把时间和空间关系描述清楚。
所以这次我把流程倒过来了。
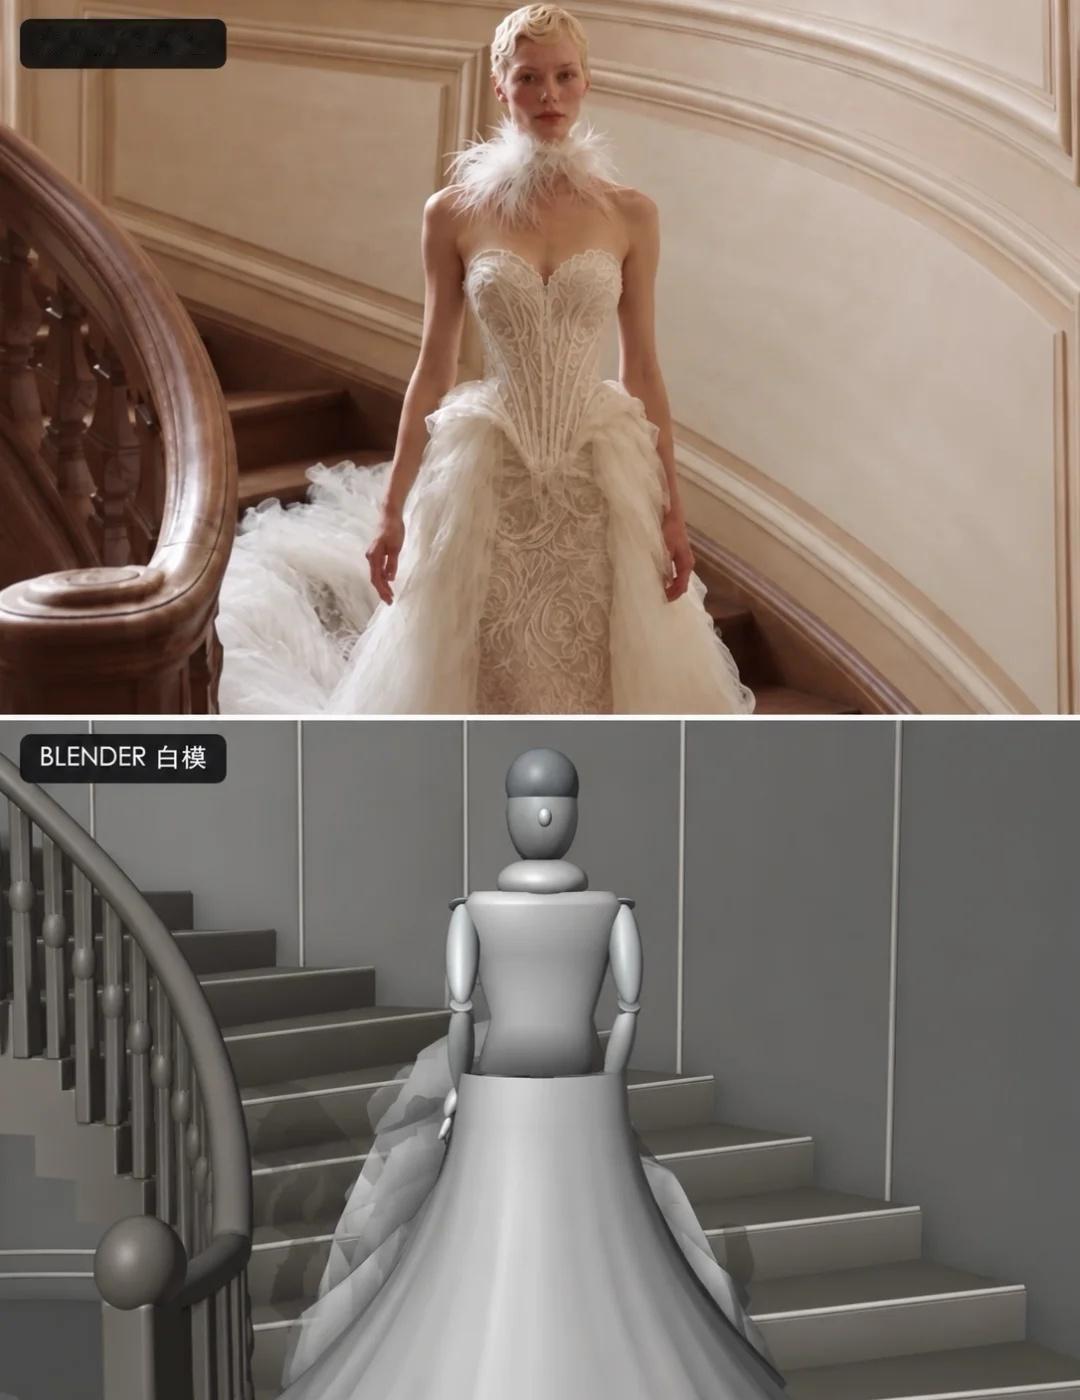
我用 Astra调用 Blender,先把一条 12 秒的婚纱广告做成 白模预演。
白模不负责好看,只负责确定这些东西:
1. 人物站在哪里
2. 人物怎么移动
3. 什么时候转身、伸手
4. 摄影机从哪里开始
5. 镜头最后停在哪里
6. 人物和楼梯会不会互相遮挡
确认动作、机位和节奏没问题以后,我再把白模预演、人物参考图和场景图一起交给 视频模型,生成最终的真人画面。
这几个素材的分工非常明确:
- 人物图:控制长相和服装
- 场景图:控制环境和质感
- Blender 白模:控制动作、空间、机位和时间
- 视频模型:补全人物表演、裙摆、材质、光影和真实感
上面是真人生成结果,下面是 Blender 白模预演。
重点不是两边的材质完全一样,而是人物运动方向、摄影机路线、空间关系和关键动作节点可以提前被控制。
这件事真正有价值的地方,是把 AI 视频从“生成以后再找问题”,变成“生成以前先解决问题”。AI视频 AIGC AI广告 AI工作流 商业广告