近期,OpenAI宣布在求解千禧年数学难题上取得大进展。在相关声明中,OpenAI承认“不能排除从用户使用产品中获得的去标识化(匿名)数据帮助改进了模型”。最近又有两名数学家发文控诉,之前曾经登上媒体头条的两个AI数学大进展,很有可能剽窃了他们的想法。一个是雅可比猜想,一个是非柔性群。昨天刚谈过这个问题,今天又多了两个例子。AI带来数学大进展是好事,但是一定要克服其弊端。一定要搞清楚,这里面有多少是从根本上依赖于数学家的(甚至未发表的)idea,乃至提前抢了他们的功劳,打乱了他们的研究计划,更糟糕的是数学家的这些idea完全没有得到应有的荣誉。
————————————数学家Andreas Thom刚发了个帖子,详细说明了这种风险的具体表现。他曾与同事使用ChatGPT探讨“扩展器匹配问题”及相关的未发表推导。不久后,OpenAI发布了关于“非柔性群”的成果,其模型采用的解题路径与Thom尚未公开的方法存在相似之处。当Thom询问OpenAI的研究人员(如Mark Sellke等人)是否使用了他的对话数据时,对方最初给出了缺乏证据的否认。
然而,结合OpenAI关于“使用去标识化数据改进模型”的说明,Thom指出了一个关键的逻辑漏洞:在数学领域,“去标识化”只能隐去研究者的名字,却无法消除一个数学思想的智力内核。如果AI提供商利用用户未公开的研究思路去改进模型,甚至抢在原作者之前发布成果,这在学术伦理上是站不住脚的。由于模型训练的内部流程对用户完全是个黑盒,研究者根本无法审计自己的核心Idea是否已经被系统提取和利用。————————————另一位数学家 ADRIAN VASIU则指控AI窃取了其雅可比猜想方面的idea,甚至完全打乱了他的研究计划。他的一份早期草稿(涉及仿射空间平展自同态分类,编号`BGV160.pdf`)曾意外在网络公开。18个月后,一份由AI生成的论文出现,其中不仅在符号使用、研究意图上与原草稿重叠,甚至使用了原作者特有的数学构造方法(如`1+xy`规则)。因为AI吸收了这些高度重合的内容,该学者不得不打乱原定于数月甚至一两年后公开研究专著的计划,在几天内仓促上传了长达百余页的论文,以保护自己的首创权。
AI公司客观上可以通过用户的交互,积累大量顶尖学者的前沿Idea。在现有机制下,只要学者使用这些模型进行实质性的学术推演,就不得不承担思路被“匿名化”征用的风险。
大模型技术的发展确实为学术研究提供了前所未有的工具,但与之伴随的数据隐私与知识产权问题也已无法回避。如何在提高科研效率的同时,保护研究者的核心“Idea”不被滥用,是学术界和AI企业需要共同解决的课题。在行业规范彻底完善之前,审慎评估工具的隐私条款,将是每一位科研工作者开展工作的前提。
全文如下:
【第一篇:Andreas Thom的文章】
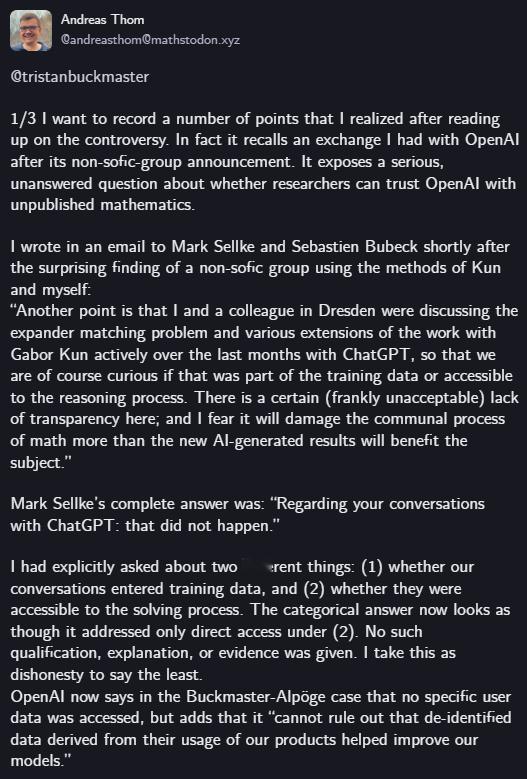
在详细了解了这场争议之后,我想记录下我意识到的一些观点。事实上,这让我想起了在OpenAI宣布关于“非柔性群(non-sofic-group)”的成果后,我与他们的一次交流。它暴露了一个严重的、尚未得到解答的问题:研究人员是否可以放心地将未发表的数学研究交给(AI公司)。
在使用Kun和我的方法得出了令人惊讶的非柔性群发现后不久,我在给 Mark Sellke 和 Sebastien Bubeck 的一封电子邮件中写道:“另一点是,在过去的几个月里,我和德累斯顿的一位同事一直在与ChatGPT积极讨论扩展器匹配问题(expander matching problem)以及与Kun合作的各种衍生工作。因此我们当然很好奇,这些内容是否成为了训练数据的一部分,或者是否在AI的推理过程中被读取了。坦率地说,这里存在着一种令人无法接受的‘缺乏透明度’;我担心它对数学共同体进程的破坏,将超过新的AI生成结果给该学科带来的好处。”
Mark Sellke 的完整回复是:“关于你与ChatGPT的对话:那并没有……”(译注:此处原文截断,大致意为“那并没有发生”)。
我当时明确问了两个不同的问题:(1) 我们的对话是否进入了训练数据;(2) 它们在模型求解过程中是否可被访问。他当时那绝对的回答,现在看来似乎只针对了“直接访问”这一情况。当时他并没有给出任何限定条件、解释或证据。退一步说,我认为这是一种不诚实的行为。(OpenAI)现在在 Buckmaster-Alpöge 事件中表示没有访问用户数据,但补充说它“不能排除从他们使用我们产品中获得的去标识化(匿名)数据帮助改进了我们的(模型)”。
OpenAI现在正在做出一种区分,而当时他们给我的答复中却抹杀了这种区分——尽管我的问题中已经明确提出了这种区分。
我们没有义务去对OpenAI的内部训练流程进行逆向工程来弄清到底发生了什么。只有OpenAI掌握相关的数据。如果 Sellke 和(Bubeck)给出了断然的否认,他们就必须披露其否认的依据:产品和隐私设置、相关的数据集和检查点(checkpoints),以及“源自使用的去标识化数据”到底是什么意思。
我在6月20日禁用了模型训练功能。但这仍然只是一个承诺,用户无法审计其执行情况,而且这也无法解答我早期的对话,或者已经被提取的衍生数据遭遇了什么。OpenAI的答复中没有提及该设置,也没有提及任何针对特定账户的检查。
这里还有一个数学上的相似之处,尽管不是那么明显。Kun和我使用的方法并不是攻克非柔性(non-soficity)问题的主要路线,事实上,沿着量子博弈等方向还有其他更有希望的路径。因此,OpenAI对我们工作的详细掌握,让我不禁怀疑模型是如何找到这条路线的。
如果用户未公开的研究改进了模型,而提供商随后利用这一点,赶在这些用户之前去抢发论文——在没有知情同意、没有披露、也没有给出致谢的情况下——这在伦理上是站不住脚的。去标识化(匿名化)也许能隐去一个名字,但它无法消除一个数学思想的智力内核。Sellke 和(Bubeck)似乎对这个简单的道德层面视而不见。
Sellke 当时那断然的回答,往轻了说,是毫无道理的宽泛和实质上的误导;回过头来看,这分明就是不诚实。
他自己承认的攻击行为,以及他试图将 Alpöge 从一篇合作论文中排挤出去的企图,引发了人们对其丧失道德底线的担忧。综合来看,这引发了对他们判断力和个人诚信的严重质疑。
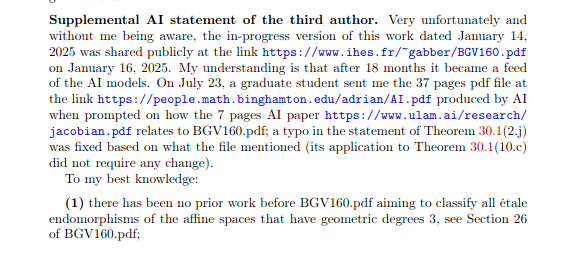
【第二篇: ADRIAN VASIU论文中的声明】第三作者关于 AI 的补充声明非常遗憾的是,在我并不知情的情况下,本研究注有2025年1月14日日期的进行中草稿版本,于2025年1月16日在链接 网页链接 上被公开分享了。据我了解,在18个月之后,该文件成为了 AI 模型的训练数据(feed)。7月23日,一位研究生给我发送了一份37页的 PDF 文件(链接 网页链接) 。该文件是由 AI 生成的,当时输入给 AI 的提示词(prompt)是询问那篇7页的 AI 论文(网页链接)与 BGV160.pdf 之间有何关联;该文件指出了定理 30.1 (2.j) 陈述中的一处笔误,并已按照文件提到的内容作了修正(其在定理30.1中的应用无需任何修改)。就我所知:(1)在 BGV160.pdf 之前,没有任何先前的研究致力于对仿射空间中所有几何次数(geometric degrees)为3的平展自同态(étale endomorphisms)进行分类,参见 BGV160.pdf 第26节;(2)在 BGV160.pdf 之前,没有任何先前的研究在开浸入(open embeddings)、态射以及平展自同态的构造中,系统地使用过 1-xy,包括由规则 (m : 1 + xy) 定义的态射;(3)在 BGV160.pdf 和那篇7页的 AI 论文之间,存在符号上的重叠(例如用 I' 表示补集)以及研究意图上的重叠(例如几何次数的变分、纤维(fibers)计数、非真轨迹(non-proper locus)、族(families)、1 + xy 的使用、正规化(normalization)X_e 的计算——这在雅可比猜想(Jacobian Conjecture)的反例中实际上并没有起到作用,等等)。这些在前面提到的37页的 PDF 文件中也有着非常中肯且系统的呈现;(4)截至目前,生成那篇7页 AI 论文背后的提示词记录(prompt history)、模型版本以及工作流程尚未被公开披露。我在2026年1月提交的西蒙斯基金会(Simons Foundation)旅行奖申请中曾提及:“关于仿射空间自同构的研究专著(与 Alexander Borisov 和 Ofer Gabber 合作,目前121页)计划于7月公开”;并且“关于仿射空间自同态与雅可比猜想(与 Alexander Borisov 和 Ofer Gabber 合作,目前138页)计划于2026年底或2027年初公开。”由于 AI 的介入,我迫于无奈,不得不将这两篇论文相隔仅4天便相继上传发布。人们或许可以深思,AI 的这种介入究竟是带来了积极还是消极的影响。当前的版本是 BGV356.pdf,日期为2026年9月4日。